我们让 swarms-rs 0.3.0 与三个使用最广泛的智能体框架进行了正面对比:Swarms(Python)15.0.3、LangGraph 1.2.12 和 CrewAI 1.15.23。所有框架都驱动同一个模型 Claude Sonnet 5.5,使用相同的智能体、相同的系统提示词和相同的任务。
结果非常明确。在所有由框架本身决定的指标上,swarms-rs 都以很大的优势领先:
| swarms-rs | Swarms(Python) | LangGraph | CrewAI |
|---|
| 冷启动(从启动到智能体就绪) | 6 ms | 2,647 ms | 780 ms | 1,439 ms |
| 启动时内存 | 3.7 MB | 250 MB | 94 MB | 179 MB |
| 每次 LLM 调用的框架耗时 | 0.11 ms | 1.11 ms | 1.77 ms | 9.68 ms |
| 100 个智能体并行(理想值 0.5 秒) | 0.52 s | 2.21 s | 0.72 s | 4.20 s |
简而言之:
- 启动快 130 到 440 倍。 swarms-rs 进程在 6 毫秒内即可开始运行智能体。
- 内存少 25 到 68 倍。 一个完整的 swarms-rs 智能体进程峰值内存只有 3.7 MB。
- 每次 LLM 调用的框架耗时少 10 到 88 倍。 swarms-rs 在每次模型调用前后只花费 0.11 毫秒。
- 接近完美的并行。 每次调用耗时 0.50 秒时,100 个智能体在 0.52 秒内全部完成,效率达 97%,内存占用仅 29 MB。
本文先说明我们测量了什么、为什么重要,再逐项介绍结果。完整的测试框架、报告和图表都已在 swarms-rust-benchmark 仓库中开源,你可以在自己的机器上重新跑出每一个数字。
为什么框架开销很重要
参与对比的所有框架调用的是同一个模型,无论请求来自哪个框架,Claude 生成回答所需的时间都是一样的。框架能够决定的,是调用之外的一切:进程启动需要多久,每个智能体占用多少内存,每次请求前后要做多少额外工作,以及当你要求并行时,究竟有多少个智能体在同时运行。
这些开销在 notebook 里很容易被忽略,到了生产环境就很难忽略了:
- 无服务器和短生命周期进程每次冷启动都要付出完整的启动成本。2.6 秒的导入时间,意味着第一个智能体开始工作之前,就已经多了 2.6 秒的延迟和计费算力。
- 高吞吐服务的每一次请求都要承担单次调用开销。规模上去之后,每次调用多出的几毫秒会累积成整台整台的机器。
- 大规模集群会把内存和调度成本乘以智能体的数量。100 个智能体用 29 MB 还是 464 MB,决定了你是能在一台机器上部署很多集群,还是需要一整个机群。
测试方法
我们在设计这套基准测试时,力求对每个框架都公平,并且易于复现。
相同的工作负载。 每个框架都用自己惯用的构件实现了三种工作流:单个智能体、三个智能体的顺序流水线(Researcher、Analyst、Writer),以及 N 个智能体针对同一任务并行展开。四个框架使用同一个共享文件中的智能体名称、系统提示词和任务。
| 工作流 | swarms-rs | Swarms(Python) | LangGraph | CrewAI |
|---|
| 单个智能体 | SwarmsAgent | Agent | 单节点 StateGraph | 单智能体 Crew |
| 顺序 | SequentialWorkflow | SequentialWorkflow | 三节点链 | Process.sequential |
| 并行 | ConcurrentWorkflow | ConcurrentWorkflow | 从 START 扇出 | 每个智能体一个 Crew.akickoff() |
相同的模型设置。 每个框架都使用 claude-sonnet-5-5,max_tokens=4096,不带工具,每个智能体只运行一轮。所有请求都经过一个本地代理并被记录下来,因此我们可以直接从请求本身确认:四个框架发送的设置完全相同,而且每次智能体运行都只发出一次 API 调用。
两组测试。
- 框架开销。 代理充当 Anthropic Messages API 的模拟服务,立即返回结果,在并行测试中则固定在 500 毫秒后返回。去掉模型和网络的影响之后,剩下可测量的就只有框架本身。
- 在 Claude Sonnet 5.5 上的真实运行。 代理把每个请求转发到真实的 Anthropic API:44 次工作流运行共 104 次 API 调用,所有框架均零错误。
干净的环境。 每个 Python 框架都安装在各自独立的虚拟环境中,不会为其他框架的依赖买单。swarms-rs 以 release 模式构建。所有框架都关闭了遥测,并且每个框架在计时开始前都先进行了一次不计入结果的预热启动,确保 Python 字节码缓存已经存在。峰值内存由包裹在每个进程外的 /usr/bin/time -l 测得。
所有测试都在 Apple M3 Pro(12 核,18 GB)上运行,环境为 Python 3.12.3 和 Rust 1.98.1。
冷启动:6 毫秒即可就绪
我们将每个框架的进程各启动十次,测量从进程启动到智能体构建完成所需的时间,同时记录峰值内存。
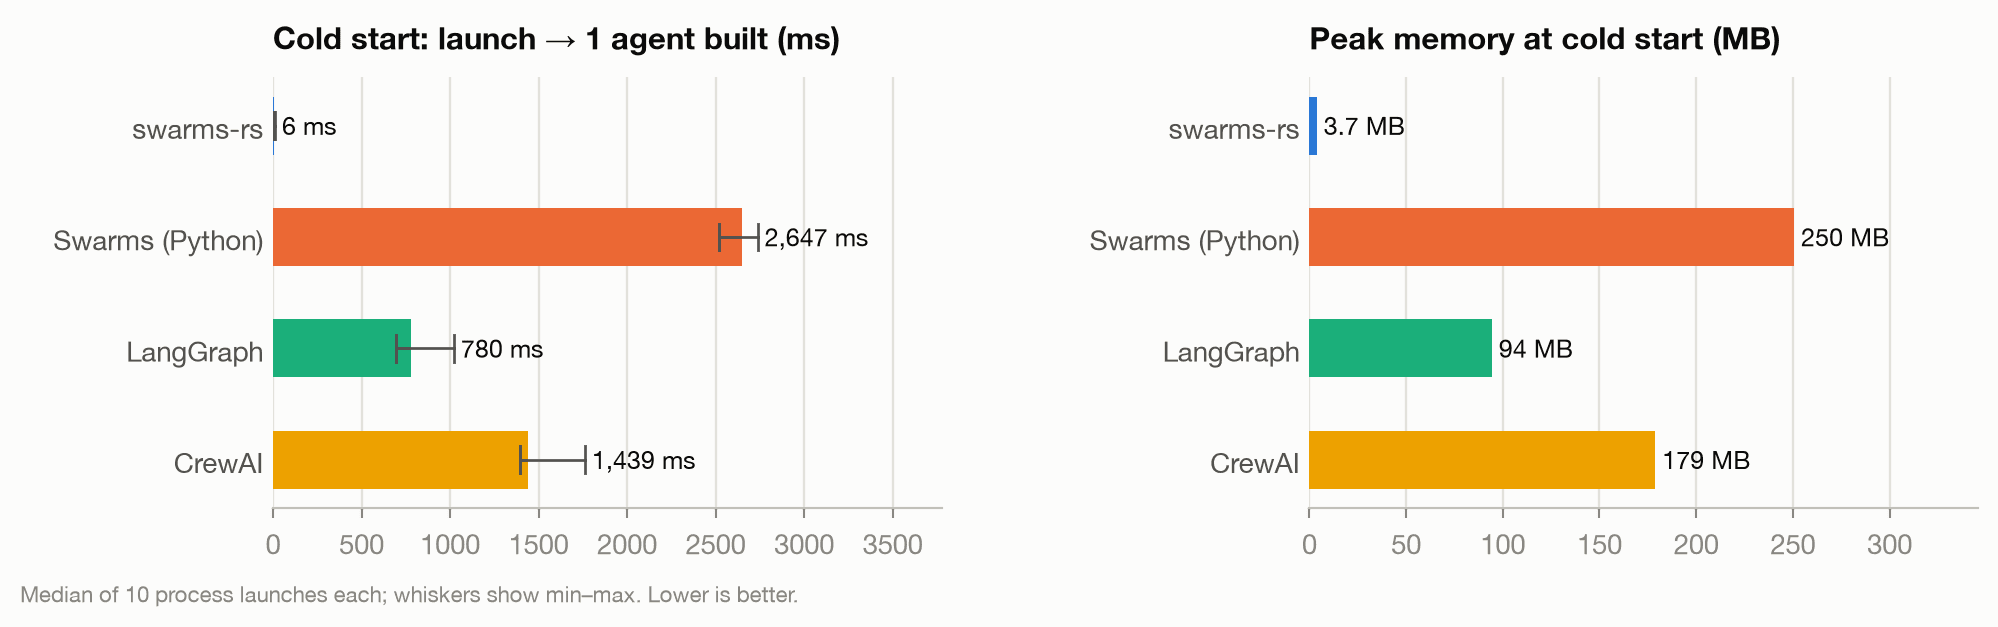
| 启动到智能体就绪 | 框架导入 | 智能体构建 | 峰值内存 |
|---|
| swarms-rs | 6 ms | 无(原生二进制) | 0.01 ms | 3.7 MB |
| Swarms(Python) | 2,647 ms | 2,312 ms | 0.92 ms | 250 MB |
| LangGraph | 780 ms | 624 ms | 1.18 ms | 94 MB |
| CrewAI | 1,439 ms | 1,065 ms | 113.52 ms | 179 MB |
swarms-rs 智能体就绪的速度比 LangGraph 快 130 倍,比 CrewAI 快 240 倍,比 Swarms(Python)快 440 倍。原因在于架构本身。Python 框架在构建智能体之前必须导入整个依赖图,仅导入一项就需要 0.6 到 2.3 秒。swarms-rs 编译成单个原生二进制文件,没有任何需要导入的东西,构建一个智能体只是普通的结构体构造,耗时约 10 微秒。
对于无服务器函数、命令行工具、CI 任务和自动扩缩容的工作节点来说,启动时间是用户最先感受到的延迟。使用 swarms-rs,这部分延迟几乎消失了。
内存:每个进程 3.7 MB
同一组运行还记录了峰值常驻内存。一个完整的 swarms-rs 进程,包括异步运行时、HTTP 客户端和一个配置好的智能体,峰值内存只有 3.7 MB。这比 LangGraph(94 MB)少 25 倍,比 CrewAI(179 MB)少 48 倍,比 Swarms(Python)(250 MB)少 68 倍。
开始真正干活之后,内存占用依然很小。在 Claude Sonnet 5.5 的真实运行中,包括三智能体流水线和并行工作流,swarms-rs 的峰值内存只有 4 到 5 MB,而 Python 框架在相同工作流中的峰值在 98 MB 到 252 MB 之间。
进程小,成本就低。你可以在内存限制严格的容器里运行 swarms-rs 智能体,可以部署在边缘设备上,也可以在一台机器上同时运行数百个。
每次 LLM 调用的框架耗时:0.11 毫秒
为了单独衡量编排成本,我们让每个框架连接立即返回结果的模拟 API,并对连续 30 次智能体运行计时。剩下的就是框架在每次调用前后自身的工作,外加一次对所有框架都相同的本地回环往返。
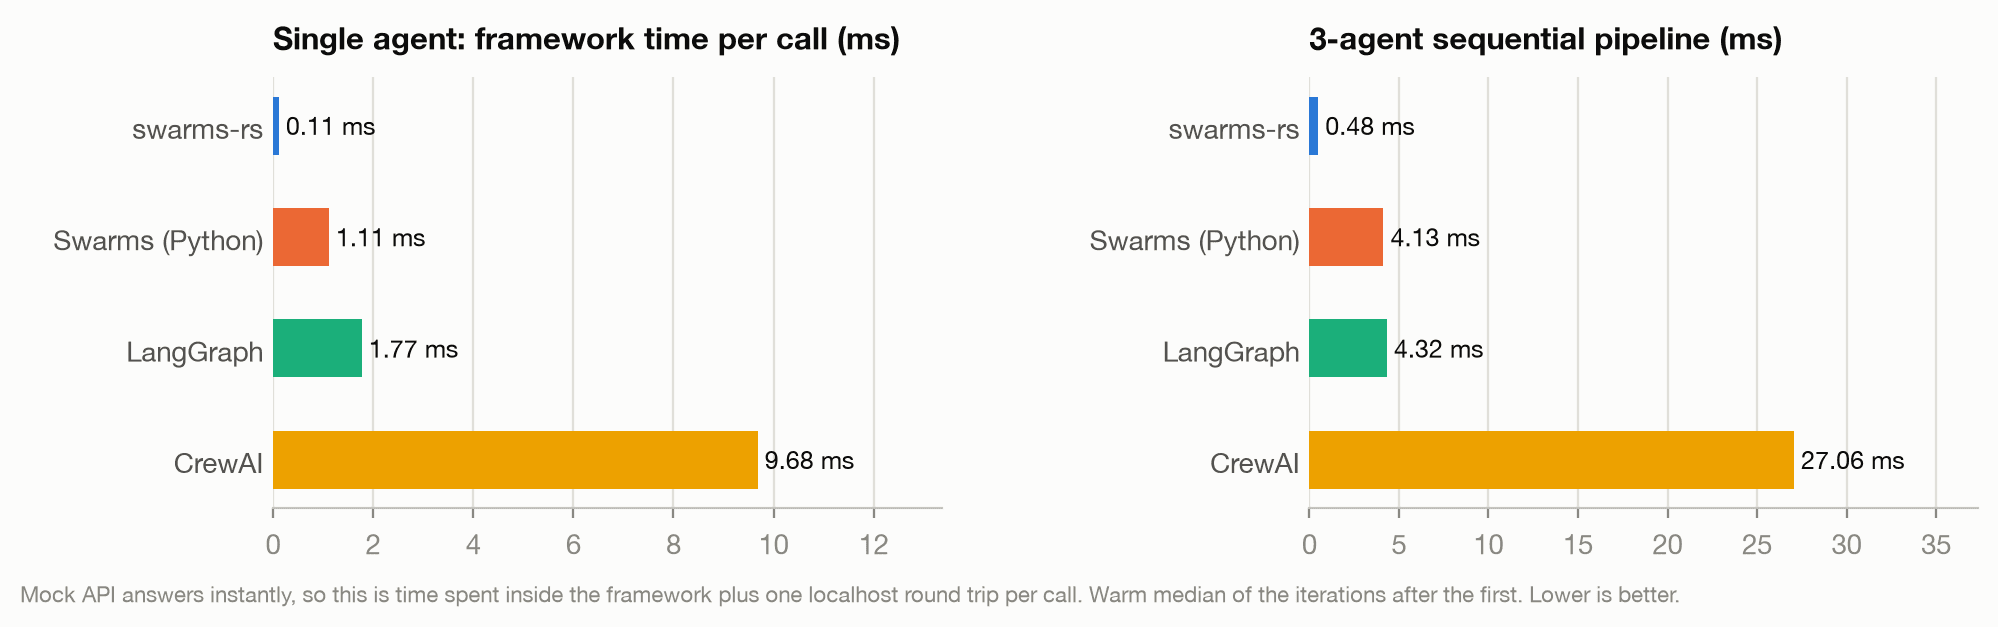
| 每次调用(预热后中位数) | 每次调用(p95) | 三智能体流水线 |
|---|
| swarms-rs | 0.11 ms | 0.16 ms | 0.48 ms |
| Swarms(Python) | 1.11 ms | 1.43 ms | 4.13 ms |
| LangGraph | 1.77 ms | 1.95 ms | 4.32 ms |
| CrewAI | 9.68 ms | 19.72 ms | 27.06 ms |
swarms-rs 每次 LLM 调用只增加 0.11 毫秒,比 Swarms(Python)少 10 倍,比 LangGraph 少 16 倍,比 CrewAI 少 88 倍。完整的三智能体顺序流水线只需 0.48 毫秒的框架时间,比其他框架少 9 到 56 倍。尾部延迟同样稳定:第 95 百分位只有 0.16 毫秒。
真实运行也印证了这一点。在调用真实 Claude API 时,我们用总运行时间减去每个请求在 API 端耗费的时间,得到的就是框架在一个全新进程中花费的时间:
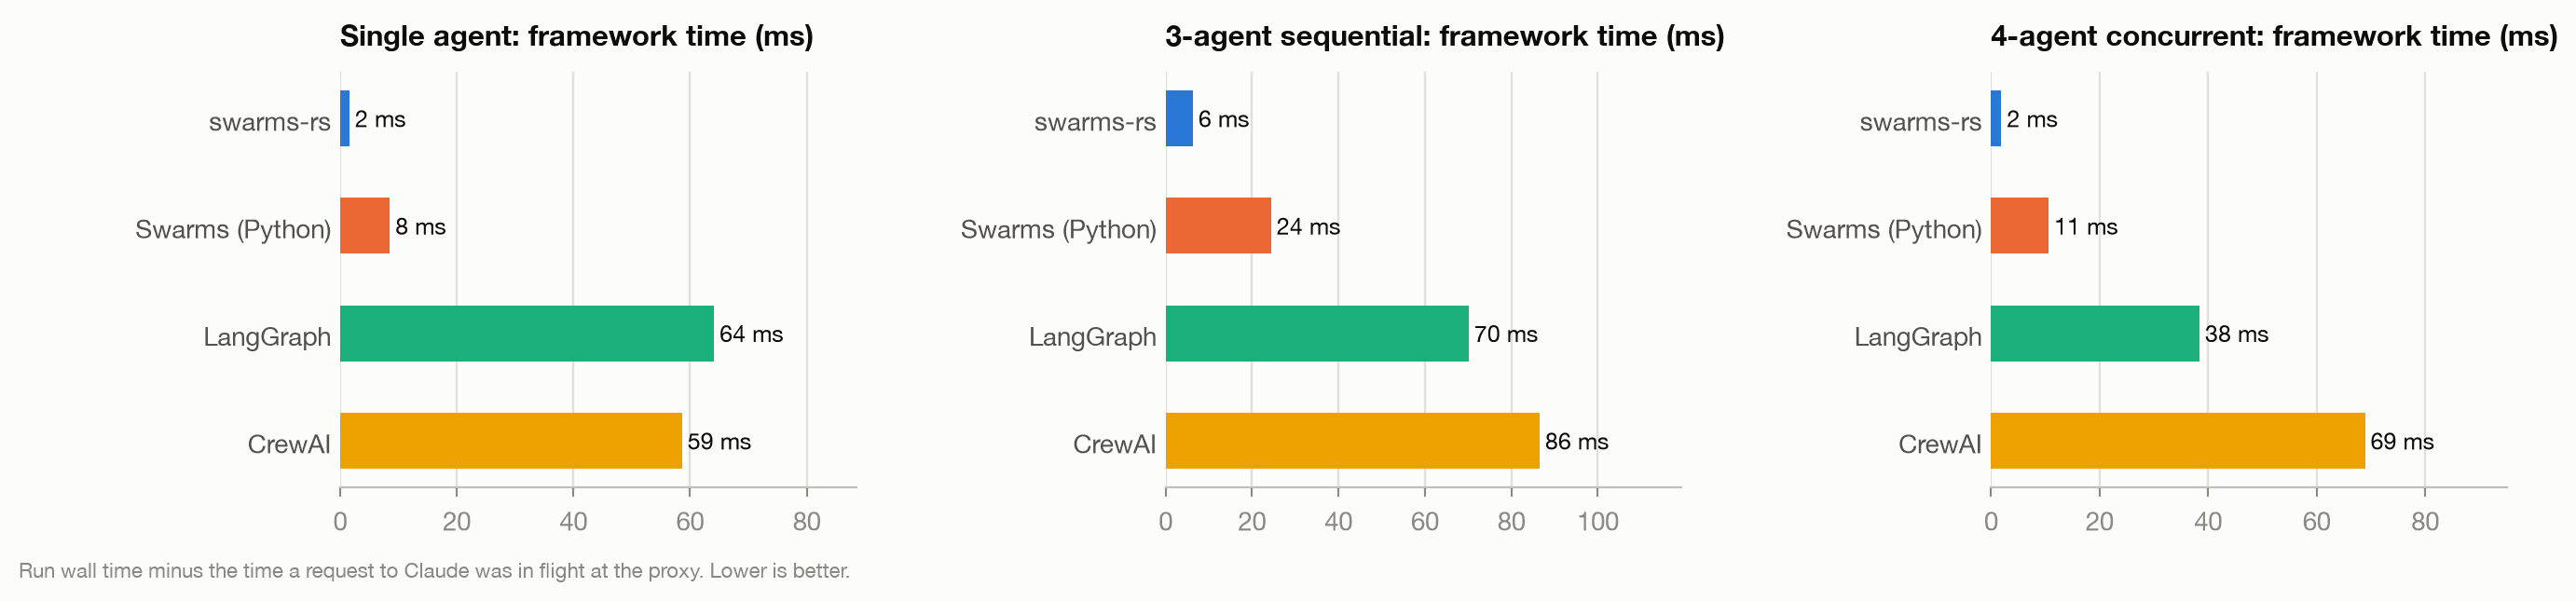
| Claude Sonnet 5.5 真实运行 | swarms-rs | Swarms(Python) | LangGraph | CrewAI |
|---|
| 单个智能体 | 2 ms | 8 ms | 64 ms | 59 ms |
| 三智能体顺序 | 6 ms | 24 ms | 70 ms | 86 ms |
| 四智能体并行 | 2 ms | 11 ms | 38 ms | 69 ms |
在所有真实工作流中,swarms-rs 自身只花费了 2 到 6 毫秒。实际效果是,模型一返回,swarms-rs 工作流就结束了。
100 个智能体并行:0.52 秒
并行测试最能体现框架设计的差异。我们把模拟 API 设置为每次调用固定耗时 500 毫秒,然后分别让 10、50 和 100 个智能体同时处理同一任务,每种规模运行五次。并行完美的框架,无论智能体数量多少,都应在 500 毫秒内完成。
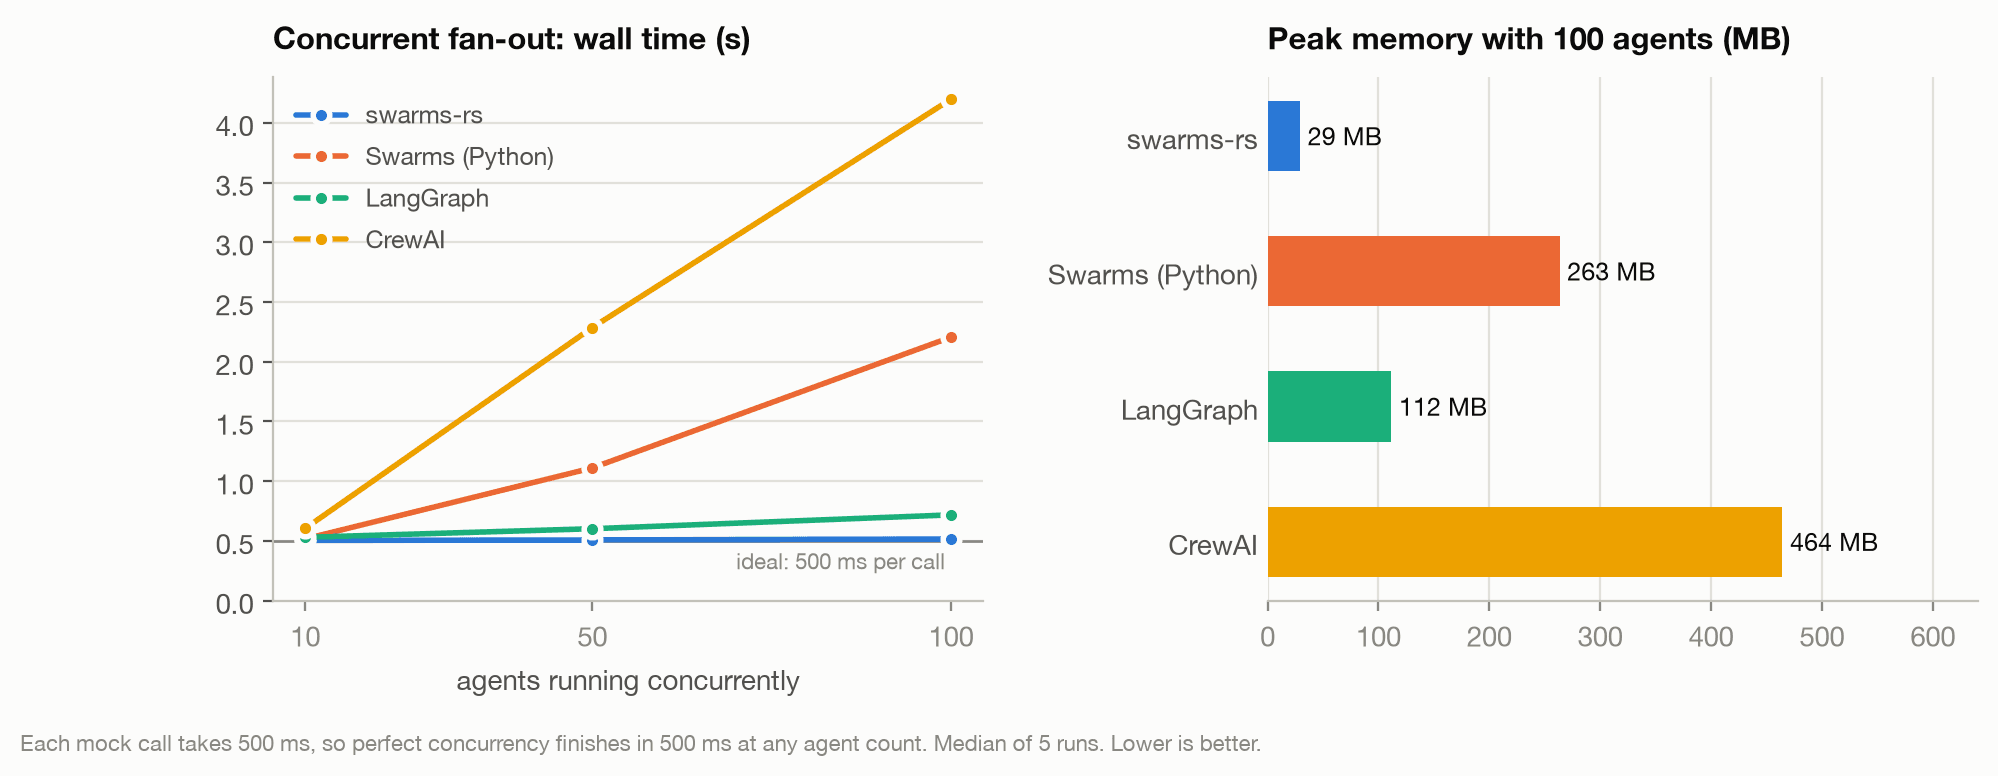
| 100 个智能体 | 总耗时 | 并行效率 | 同时在途请求峰值 | 峰值内存 |
|---|
| swarms-rs | 0.52 s | 97% | 100 | 29 MB |
| LangGraph | 0.72 s | 70% | 100 | 112 MB |
| Swarms(Python) | 2.21 s | 23% | 32 | 263 MB |
| CrewAI | 4.20 s | 12% | 16 | 464 MB |
swarms-rs 在 0.52 秒内完成 100 个智能体,距离理论最优只差 16 毫秒,而且在每种规模下都保持这一水平:10 个智能体 0.504 秒,50 个 0.508 秒,100 个 0.516 秒。整个过程只用了 29 MB 内存,比其他框架少 4 到 16 倍。
代理记录了每个框架实际同时发出的请求数量,这解释了结果之间的差距:
- swarms-rs 同时发出了全部 100 个请求。
ConcurrentWorkflow 把每个智能体作为 Tokio 运行时上的轻量级 future 来驱动,等待网络的智能体几乎不消耗任何资源。所有智能体都是同一个 Anthropic 客户端的克隆,因此共享同一个连接池。
- LangGraph 同样达到了 100 个同时在途的请求,但每次调用都要在 Python 的单个事件循环上做不少工作,所以到 100 个智能体时效率降到 70%。
- Swarms(Python) 默认同时运行 32 个智能体,这个上限是为了避免触发模型提供商的速率限制。调高
max_workers 即可进一步扩大并行度。
- CrewAI 同时在途的请求从未超过 16 个,因此 100 个智能体大约要分七批运行。
并行的智能体团队是多智能体系统的核心:专家小组、对文档做 map-reduce、多模型集成,都依赖于此。swarms-rs 可以在几乎不增加时间和内存的前提下,把这些团队扩展到很大的规模。
这对你意味着什么
如果你正在构建需要快速启动、保持轻量或大规模并行的智能体,swarms-rs 让框架不再成为瓶颈:
- 无服务器和边缘部署获得 6 毫秒的冷启动和个位数 MB 的进程。
- 高吞吐服务每次调用只在编排上花费十分之一毫秒,算力都留给真正的工作。
- 大规模集群以 97% 的效率、29 MB 的内存并行运行 100 个智能体。
- Rust 服务可以直接嵌入智能体,使用与 Swarms 生态其他部分相同的智能体、工作流和模型提供商。
复现测试结果
完整的测试框架位于 swarms-rust-benchmark 仓库中,包括共享任务文件、每个框架各一份的基准测试程序、负责记录的代理,以及生成本文所有表格和图表的脚本。运行测试后,逐次运行的原始数据和日志会写入你自己的机器。
git clone https://github.com/The-Swarm-Corporation/swarms-rust-benchmark
cd swarms-rust-benchmark

for env in swarms langgraph crewai harness; do
  uv venv -q --python 3.12 .venvs/$env
  VIRTUAL_ENV=.venvs/$env uv pip install -r requirements/$env.txt
done

.venvs/harness/bin/python harness/run.py --suite mock   # 框架开销,约 3 分钟,不产生 API 费用
.venvs/harness/bin/python harness/run.py --suite live   # 真实 Claude 调用,需要 ANTHROPIC_API_KEY
.venvs/harness/bin/python harness/compare.py            # 生成表格和图表
开始使用 swarms-rs
把 swarms-rs 添加到你的项目中:
cargo add swarms-rs@0.3
cargo add tokio --features full
cargo add anyhow
export ANTHROPIC_API_KEY="sk-ant-..."
下面就是基准测试中的并行工作流:四位分析师在 Claude Sonnet 5.5 上同时评审同一份提案。
use swarms_rs::{
    agent::SwarmsAgentBuilder,
    llm::provider::anthropic::Anthropic,
    structs::{agent::Agent, concurrent_workflow::ConcurrentWorkflow},
};

#[tokio::main]
async fn main() -> anyhow::Result<()> {
    // 从环境变量读取 ANTHROPIC_API_KEY。
    let model = Anthropic::from_env_with_model("claude-sonnet-5-5");

    let roles = [
        ("Technical-Analyst", "Evaluate the proposal from an engineering and scalability perspective."),
        ("Financial-Analyst", "Evaluate the proposal from a cost, revenue and unit-economics perspective."),
        ("Risk-Analyst", "Evaluate the proposal from an operational and security risk perspective."),
        ("Regulatory-Analyst", "Evaluate the proposal from a compliance and licensing perspective."),
    ];

    let agents: Vec<Box<dyn Agent>> = roles
        .iter()
        .map(|(name, prompt)| {
            Box::new(
                SwarmsAgentBuilder::new_with_model(model.clone())
                    .agent_name(*name)
                    .system_prompt(*prompt)
                    .max_loops(1)
                    .build(),
            ) as Box<dyn Agent>
        })
        .collect();

    let workflow = ConcurrentWorkflow::builder()
        .name("ProposalReview")
        .agents(agents)
        .build();

    // 四个智能体同时调用 Claude。
    let result = workflow
        .run("Evaluate launching a stablecoin payments product for small businesses in the EU.")
        .await?;
    println!("{result}");
    Ok(())
}
了解更多:
- 阅读 Swarms Rust v0.3.0 发布说明,了解 OpenRouter、
AnyModel、子智能体与交接。
- 在 docs.rs/swarms-rs 浏览 API 文档。
- 在 GitHub 上为项目加星并关注更新。