指南工程
如何用 Python 把 AI 智能体变成 MCP 服务器(带认证)
用 Swarms MCPDeployer 在 Python 中把 AI 智能体变成 MCP 服务器:API key、自定义认证、token 校验器、把 swarm 作为工具,以及一个调用它的客户端智能体。
Swarms 团队10 分钟阅读

用 Swarms MCPDeployer 在 Python 中把 AI 智能体变成 MCP 服务器:API key、自定义认证、token 校验器、把 swarm 作为工具,以及一个调用它的客户端智能体。
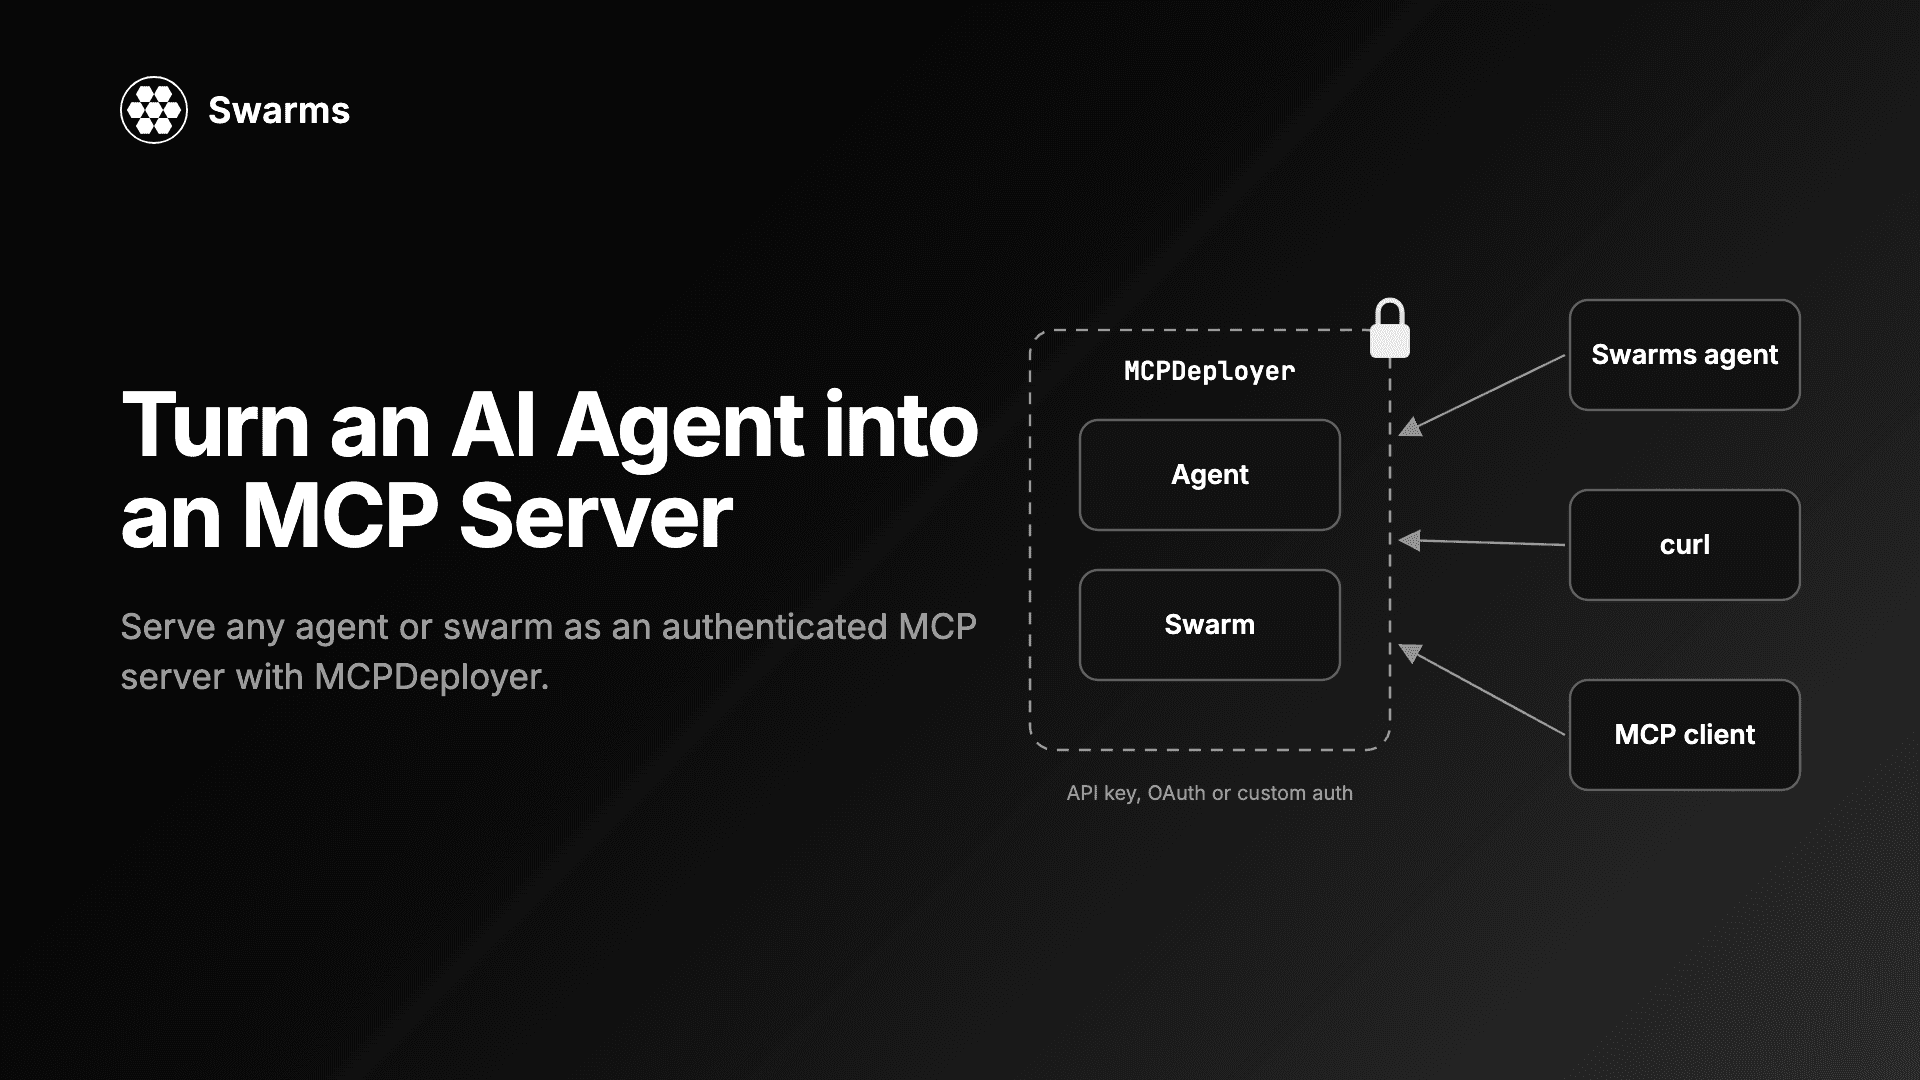
Model Context Protocol(MCP)是 AI 应用发现和调用工具的方式。大多数智能体框架都能调用 MCP 服务器,但能让你用手头已有的智能体轻松地在 Python 中构建 MCP 服务器的却不多。本指南演示如何用 MCPDeployer 把 AI 智能体变成 MCP 服务器,它随 Swarms v16 发布。你将把一个智能体放在 API key 之后对外提供,让第二个智能体连接它,从一台服务器上提供整个 swarm 和多个工具,并在几种认证方式之间做出选择。下面的每个代码块在发布前都针对 Swarms 16 的代码实际运行过。
为什么要把智能体变成服务器?因为这样任何 MCP 客户端都能使用它,而不只是 Swarms 代码。一个你调好的研究智能体,会变成另一个智能体、IDE 助手或脚本都能通过 HTTP 调用的工具,而且请求在到达你的模型之前就会先校验凭据。
本文讲的是用 Python 自托管。如果你不想自己运行服务器,Swarms 也提供托管版本:Swarms Cloud MCP 服务器在一个 URL 上把智能体和 swarm 作为工具提供,Swarms Marketplace MCP 服务器让智能体能在市场上搜索和发布,MCP Portal 则收录了社区的 MCP 服务器。
pip install -U swarms
# or
uv pip install -U swarms
示例使用 OpenAI 的 gpt-5.4-mini,所以要设置 OpenAI key:
export OPENAI_API_KEY="sk-..."你也可以把同样一行写进 .env 文件,Swarms 会自动加载它。然后检查版本:
python -c "import swarms; print(swarms.__version__)"MCPDeployer 需要 Swarms 16 或更高版本。它构建在 mcp 包的 2.x 系列之上;全新安装会自动解析到它(我们的测试环境装到的是 mcp 2.3.0),但固定在 mcp 1.x 的旧环境需要执行 pip install -U "mcp>=2"。
MCPDeployer 接收一个目标、一个目标列表,或者一个从工具名映射到目标的字典。目标可以是一个 Agent、任何带 run(task) 方法的对象(SequentialWorkflow、SwarmRouter、TreeOfThoughts……),或者一个接收任务字符串的普通 Python 函数。每个目标都会成为一个 MCP 工具,输入 schema 为 (task, img)。
MCP 端点前面有一层认证。每个 HTTP 请求在到达传输层之前都要经过它,未通过的请求会得到带 WWW-Authenticate: Bearer 的 401。如果没有配置任何认证,构造函数会拒绝构建服务器,除非你用 allow_anonymous=True 明确放开,所以你不会意外发布一个完全开放的智能体。
代码中的默认值:绑定到 127.0.0.1:8000,在 /mcp 上提供 streamable HTTP,并让 /health 对负载均衡器保持开放。
创建 server.py:
from swarms import Agent, MCPDeployer

researcher = Agent(
    agent_name="Researcher",
    agent_description="Answers a research question in one short, factual paragraph.",
    system_prompt="You are a careful researcher. Answer in one short paragraph.",
    model_name="gpt-5.4-mini",
    max_loops=1,
    output_type="final",
    print_on=False,
)

deployer = MCPDeployer(
    researcher,
    api_keys=["sk-local-dev"],
    port=8000,
)

if __name__ == "__main__":
    deployer.run()
运行 python server.py。run() 会阻塞,并打印一个包含工具名、端点和认证方式的横幅。工具名是 researcher,即 agent_name 的 snake_case 形式;工具描述是智能体的 agent_description,调用方的模型正是读它来决定是否使用这个工具。output_type="final" 让工具只返回答案;Agent 的默认设置会返回整个对话记录。
在第二个终端里,检查公开的健康检查路由,并确认 MCP 端点会拒绝没有 key 的请求:
curl -s http://127.0.0.1:8000/health
curl -s -o /dev/null -w "%{http_code}\n" -X POST http://127.0.0.1:8000/mcp
我们得到的结果:
{"status":"ok","name":"researcher","tool":"researcher","tools":["researcher"],"transport":"streamable-http"}
401
保持服务器运行,创建 client.py。客户端是一个普通的 Swarms 智能体,它的 mcp_url 是一个携带 key 的 MCPConnection:
from swarms import Agent, MCPConnection

client = Agent(
    agent_name="Client",
    system_prompt="Answer by calling the researcher tool, then repeat its answer.",
    model_name="gpt-5.4-mini",
    max_loops=1,
    output_type="final",
    print_on=False,
    mcp_url=MCPConnection(
        url="http://127.0.0.1:8000/mcp",
        api_key="sk-local-dev",
    ),
)

print(client.run("Who created the Model Context Protocol, and when?"))
客户端在启动时获取工具列表,它的模型决定调用 researcher,服务器运行研究智能体,结果作为工具响应返回。我们这次运行打印出:
The Model Context Protocol (MCP) was created by Anthropic, and it was first announced/released in November 2024.
MCPConnection 默认把 api_key 以 Authorization: Bearer <key> 的形式发送。MCPDeployer 既接受这个头,也接受 x-api-key 头,所以两种客户端的默认方式都无需额外配置就能工作。用完后按 Ctrl+C 停止服务器。
在别人开始使用你的服务器之前,这一部分要先弄明白。当目标是一个 Agent 实例时,这一个实例会服务所有调用,而 Agent 会在多次运行之间保留它的对话记录。我们在去掉 output_type="final" 的第 1 步服务器上测试过:先发送 "Remember this codeword: PELICAN-42",再在另一次单独的调用里问 "What codeword did I give you earlier?"。第二次调用回答了 PELICAN-42,而且工具结果里还包含了第一次调用的文本。在有多个用户的服务器上,一个调用方的输入会进入另一个调用方的答案。
还有并发问题。MCPDeployer 在工作线程中运行每次工具调用,所以两个客户端同时调用同一个工具时,会同时运行同一个目标对象。
解决办法是对外提供一个函数,在每次调用时构建智能体。在我们的测试中构建一个 Agent 大约需要 70 毫秒,和模型调用相比很小。创建 server_per_call.py:
from swarms import Agent, MCPDeployer


def research(task: str) -> str:
    """Answers a research question in one short, factual paragraph."""
    agent = Agent(
        agent_name="Researcher",
        system_prompt="You are a careful researcher. Answer in one short paragraph.",
        model_name="gpt-5.4-mini",
        max_loops=1,
        output_type="final",
        print_on=False,
    )
    return agent.run(task)


deployer = MCPDeployer(research, api_keys=["sk-local-dev"], port=8000)

if __name__ == "__main__":
    deployer.run()
现在工具以函数名命名为 research,描述是 docstring 的第一行。同样的两次调用测试先返回 OK,再返回 NONE。对于单用户、而且你就是想要延续上下文的服务器(比如一个应该记住上一次请求的个人助手),保留共享的 Agent 目标即可。
传入一个字典就能提供多个目标,每个目标使用你选择的工具名。下面这台服务器同时提供一个智能体、一个由两个智能体组成的 SequentialWorkflow 和一个普通函数。创建 team_server.py:
from swarms import Agent, MCPDeployer, SequentialWorkflow

researcher = Agent(
    agent_name="Researcher",
    agent_description="Lists the five most important facts about a topic.",
    system_prompt="List the five most important facts about the topic. Be brief.",
    model_name="gpt-5.4-mini",
    max_loops=1,
    output_type="final",
    print_on=False,
)

writer = Agent(
    agent_name="Writer",
    system_prompt="Turn the facts you are given into one tight paragraph.",
    model_name="gpt-5.4-mini",
    max_loops=1,
    output_type="final",
    print_on=False,
)

briefing = SequentialWorkflow(
    name="Briefing-Pipeline",
    description="Researches a topic, then writes a one-paragraph briefing.",
    agents=[researcher, writer],
    max_loops=1,
    output_type="final",
)


def word_count(task: str) -> int:
    """Counts the words in a piece of text."""
    return len(task.split())


deployer = MCPDeployer(
    {
        "research": researcher,
        "write_briefing": briefing,
        "word_count": word_count,
    },
    name="Editorial-Team",
    api_keys=["sk-local-dev"],
    port=8000,
    timeout=300,
)

if __name__ == "__main__":
    deployer.run()
描述来自各个目标:智能体的 agent_description、工作流的 description、函数的 docstring。name 是向客户端公布的服务器名。add_tool(target, name=..., description=...) 可以在 run() 之前再注册一个目标;两个目标使用同一个工具名时会在构造时报错,而不是等到第一次调用。extra_tools=[...] 会把普通函数按它们自己的签名作为工具提供,而目标始终使用 (task, img) schema。
SequentialWorkflow 会在每次运行开始时重置它的对话记录,所以它的轮次不会从一次调用延续到下一次。research 这一项就是第 3 步警告中提到的共享 Agent 实例;在多用户服务器上,请换成按次构建的函数。
如果想直接调用工具、而不是让模型来选择,可以使用 MCPManager,这是 Swarms 智能体内部用来和 MCP 服务器通信的类。创建 team_client.py:
from swarms import MCPConnection, MCPManager

manager = MCPManager(
    mcp_url=MCPConnection(
        url="http://127.0.0.1:8000/mcp",
        api_key="sk-local-dev",
        tool_timeout=300,
    )
)

print(manager.list_tool_names())

result = manager.call_tool("word_count", {"task": "four words right here"})
print(result["result"])

result = manager.call_tool("write_briefing", {"task": "The James Webb Space Telescope"})
print(result["result"])
我们这次运行先打印出 ['research', 'write_briefing', 'word_count'],然后是 4,接着是一段关于这台望远镜的镜面、红外仪器、L2 轨道和 2021 年发射的单段简报。
服务器上的 timeout=300 限制单次工具调用的时长。调用超时后,客户端会收到一个工具错误,而不是一个挂起的请求。我们用一个在 timeout=1 之后睡眠三秒的函数验证过:客户端在 1.04 秒后拿到了 is_error: True。Python 无法杀死线程,所以目标会在后台继续运行,它迟到的结果会被丢弃。一次永远不返回的模型调用是值得提前设计应对的失败模式之一,而这就是针对它的防护。
客户端也有自己的上限。MCPConnection(tool_timeout=...) 默认是 120 秒,所以一个跑在 300 秒服务器超时之后的两智能体流水线,需要在客户端设置相匹配的值,就像 team_client.py 里那样。
MCPDeployer 按固定顺序检查凭据,由第一个已配置的方式做决定,其余方式不会再被查看。
auth:你自己的函数,签名为 (credential, headers),同步或异步都可以。返回真值则放行请求,返回字典会被保存为该请求的 claims,返回假值或抛出异常则拒绝。token_verifier:一个实现了 mcp 包 TokenVerifier 协议的对象。过期时间会被检查,required_scopes 也会被检查。api_keys 和 api_key_env:静态 key,以常量时间比较。api_key_env 指定一个保存逗号分隔 key 的环境变量,在构造时读取。allow_anonymous=True:完全不认证。适用于本地开发和 stdio 传输。因为顺序是严格的,设置了 auth 时 api_keys 会被忽略。如果你想在租户规则之外再加一个所有者 key,就在你的 auth 函数里同时检查两者。
你的函数收到的 credential 来自 x-api-key 头(可以用 api_key_header 改名,Bearer 前缀会被去掉),或者作为后备来自 Authorization: Bearer。
生产环境的 key 应该从环境变量读取,而不是写在源文件里:MCPDeployer(research, api_key_env="MCP_SERVER_KEYS"),配合 MCP_SERVER_KEYS="key-a,key-b"。如果这个变量为空,构造函数会抛出 No auth configured,所以缺失的密钥会在启动时失败,而不是对外提供一个开放端点。
这台服务器只在 key 与 x-tenant 头中指定的租户匹配时才放行请求。为了让认证示例保持简短,它们提供的是一个普通函数;换成任何智能体或 swarm,用法完全一样。创建 auth_custom.py:
import hmac

from swarms import MCPDeployer

TENANT_KEYS = {"acme": "acme-secret", "globex": "globex-secret"}


def echo(task: str) -> str:
    """Returns the task unchanged."""
    return task


def tenant_auth(credential, headers):
    """Admits a request whose key matches the tenant named in x-tenant."""
    expected = TENANT_KEYS.get(headers.get("x-tenant", ""))
    if not expected or not credential:
        return False
    if not hmac.compare_digest(credential, expected):
        return False
    return {"subject": headers["x-tenant"], "scopes": ["run"]}


deployer = MCPDeployer(echo, auth=tenant_auth, port=8000)

if __name__ == "__main__":
    deployer.run()
带上 x-tenant: acme 时,key acme-secret 通过了,globex-secret 得到 401。这个函数可以是 async 的,所以它可以去数据库查 key,或者调用内部的认证服务。
对于 OAuth 风格的 bearer token,传入 token_verifier。它的 verify_token 返回一个 AccessToken 或 None。在生产环境中它会校验 JWT,或者调用你的身份提供方的 introspection 端点;这里用一个字典代替。创建 auth_token.py:
import time

from mcp.server.auth.provider import AccessToken

from swarms import MCPDeployer

ISSUED = {
    "tok-ops": AccessToken(
        token="tok-ops",
        client_id="ops-team",
        scopes=["agent:run"],
        expires_at=int(time.time()) + 3600,
    ),
    "tok-dashboard": AccessToken(
        token="tok-dashboard",
        client_id="dashboard",
        scopes=["agent:read"],
    ),
}


class StaticTokenVerifier:
    async def verify_token(self, token: str):
        return ISSUED.get(token)


def echo(task: str) -> str:
    """Returns the task unchanged."""
    return task


deployer = MCPDeployer(
    echo,
    token_verifier=StaticTokenVerifier(),
    required_scopes=["agent:run"],
    port=8000,
)

if __name__ == "__main__":
    deployer.run()
Authorization: Bearer tok-ops 被放行。tok-dashboard 是一个有效 token,但没有 agent:run scope,所以得到 401。
public_paths 列出跳过认证的路径,默认是 /health。传入它会替换默认值,而不是追加:设置 public_paths=["/metrics"] 后,我们对 /health 的请求得到了 401。如果你的负载均衡器会探测 /health,请把它加进列表。
服务器通过 streamable HTTP 使用标准 MCP 协议,所以客户端只需要发送 JSON-RPC 和一个请求头。在第 1 步的服务器运行时,curl 就能直接调用工具:
curl -s -X POST http://127.0.0.1:8000/mcp \
  -H "x-api-key: sk-local-dev" \
  -H "Content-Type: application/json" \
  -H "Accept: application/json, text/event-stream" \
  -d '{"jsonrpc":"2.0","id":1,"method":"tools/call","params":{"name":"researcher","arguments":{"task":"In one sentence: what is the Model Context Protocol?"}}}'
回复以一个 server-sent event 的形式到达:
event: message
data: {"jsonrpc":"2.0","id":1,"result":{"content":[{"text":"The Model Context Protocol (MCP) is an open standard for connecting AI models and applications to external tools, data sources, and services in a consistent way.","type":"text"}],"isError":false,"structuredContent":{"result":"The Model Context Protocol (MCP) is an open standard for connecting AI models and applications to external tools, data sources, and services in a consistent way."}}}
tools/list 的用法相同。服务器默认以无状态方式运行(stateless_http=True),所以这些单独的请求无需先进行 initialize 握手就能工作,同样的设置也让你可以在负载均衡器后面运行多个副本。传入 json_response=True 可以得到普通 JSON 回复,而不是事件流。任何支持 streamable HTTP 并允许设置请求头的 MCP 客户端,都可以用同样的方式连接。
transport="sse" 在 /sse 上提供较早的 SSE 传输。对于以 /sse 结尾的 URL,Swarms 客户端会自动选择 SSE,因为在 v16 中 MCPConnection.transport 默认是 "auto"。transport="stdio" 用于以子进程方式启动服务器的桌面 MCP 宿主。stdio 不携带请求头,所以认证不适用;请传入 allow_anonymous=True,并把宿主视为边界。host="0.0.0.0" 让其他机器可以访问服务器。MCPDeployer 通过 uvicorn 提供明文 HTTP,所以在 key 穿过网络之前,请用反向代理在前面加上 TLS。start() 和 stop(),或者 with MCPDeployer(...) as server:,会在后台线程中运行服务器,这在测试中很方便。verbose=True 会记录每一次被放行的调用。每次被调用时,它仍然是一次普通的 Swarms 运行,所以智能体照常记录自己的 token 用量。想知道你的服务器每次调用花了多少钱,请看如何在 Python 中追踪 LLM 的 token 用量与成本。
安装 Swarms 16 或更高版本,构建你的 Agent,然后把它和至少一种认证方式一起传给 MCPDeployer:MCPDeployer(agent, api_keys=["..."]).run()。这个智能体就会成为 http://127.0.0.1:8000/mcp 上的一个 MCP 工具。对于有多个用户调用的服务器,请像第 3 步那样提供一个按次构建智能体的函数。
使用 MCPDeployer 时,传入 api_keys 或 api_key_env 使用静态 key,传入 auth 使用你自己的检查,或者传入 token_verifier 加 required_scopes 使用 OAuth 风格的 token。被拒绝的请求会得到 401。没有配置认证的服务器会拒绝启动,除非你设置 allow_anonymous=True。
可以。任何带 run(task) 方法的结构都是合法目标,包括 SequentialWorkflow、SwarmRouter、HierarchicalSwarm 和 TreeOfThoughts。传入一个字典即可用你选择的名字提供多个目标;对于耗时较长的流水线,请同时调高服务器的 timeout 和客户端的 tool_timeout。
不需要。服务器通过 streamable HTTP 使用标准 MCP 协议。任何能发送 JSON-RPC、并带上 x-api-key 或 Authorization: Bearer 头的客户端,都能列出并调用它的工具,正如 curl 示例所示。
当智能体、它的提示词或数据需要留在你自己的基础设施上,或者你想要自己的认证规则时,选择自托管。如果你想把智能体和 swarm 作为工具使用、又不想运行任何服务器,就用托管的 Swarms Cloud MCP 服务器。
Swarms v16 发布说明介绍了 MCPDeployer 以及让 timeout= 变得可靠的超时修复,示例位于 Swarms 仓库的 examples/mcp/mcp_deployer 中。
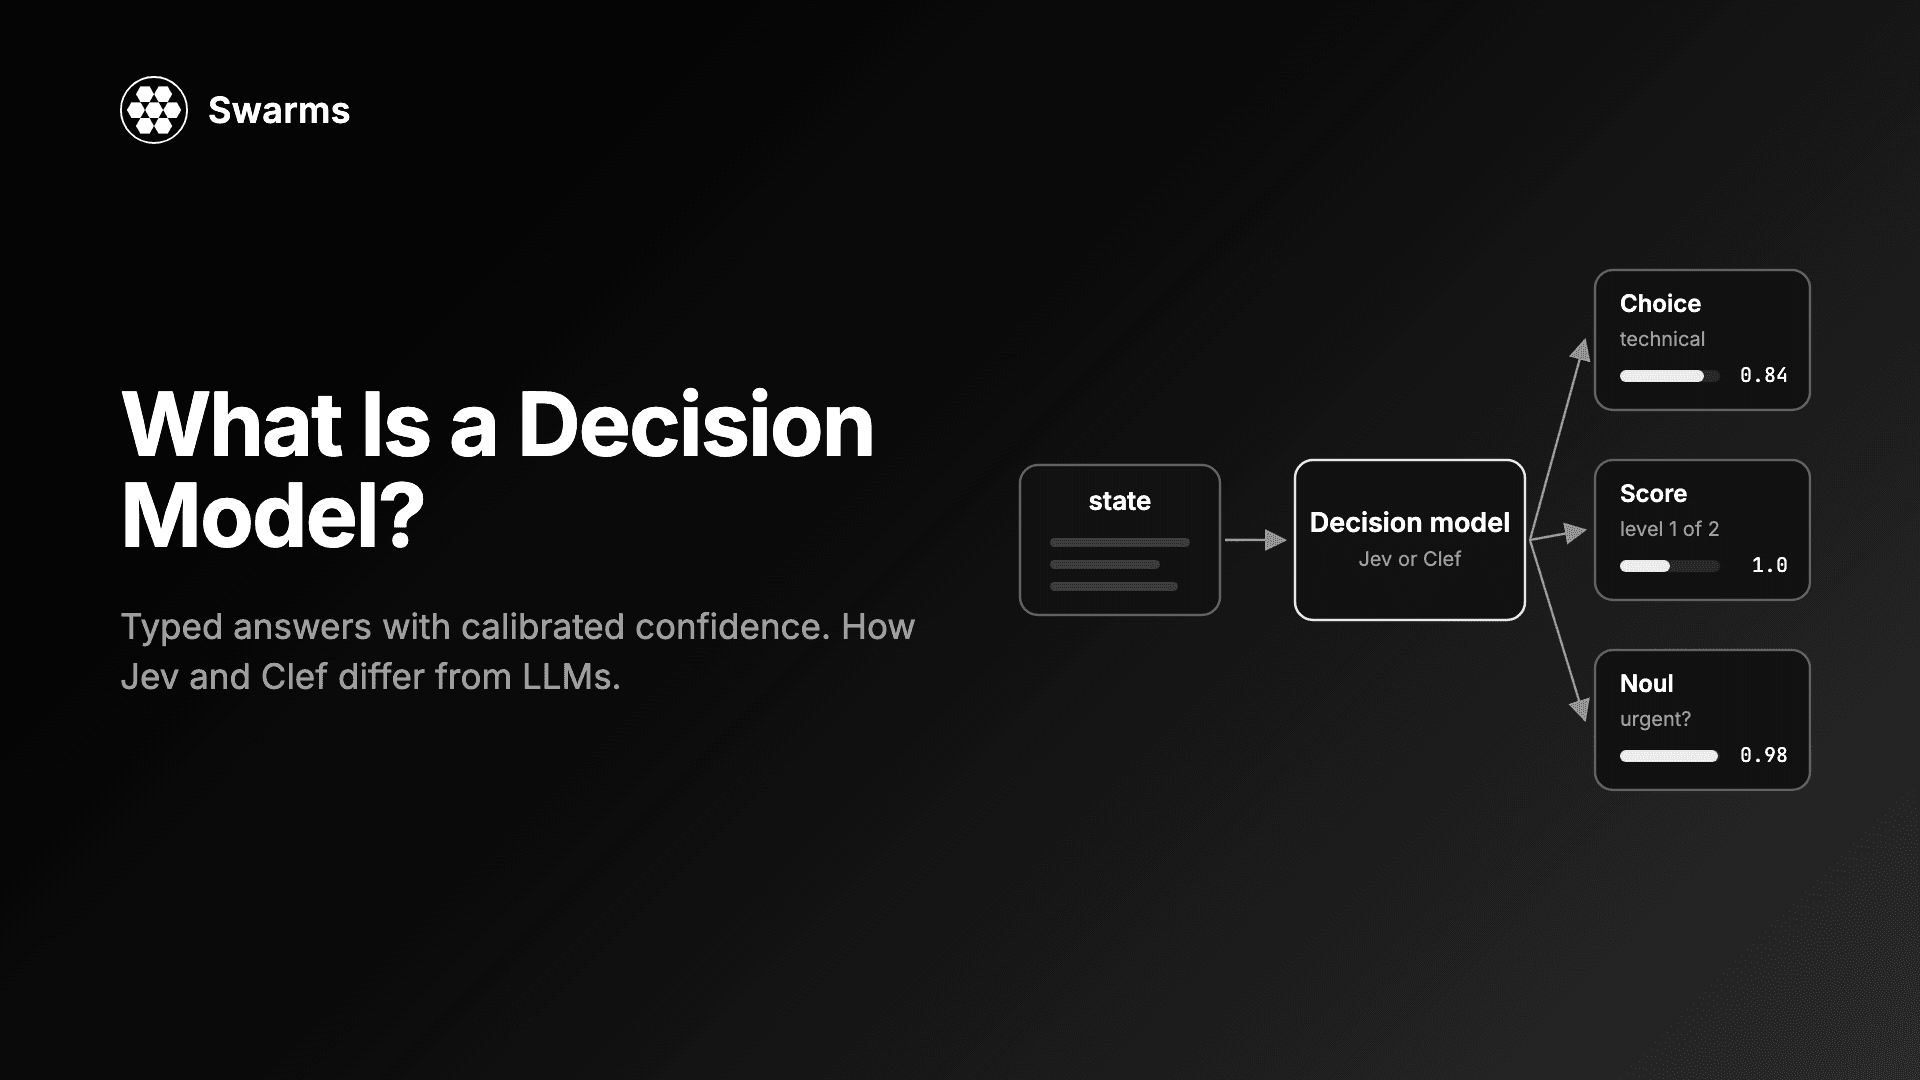
什么是决策模型?TypeSafe Jev 与 Cloudflare Clef 如何用经过校准的置信度回答带类型的问题,而不是生成文本,以及如何在 Swarms 中使用它们。
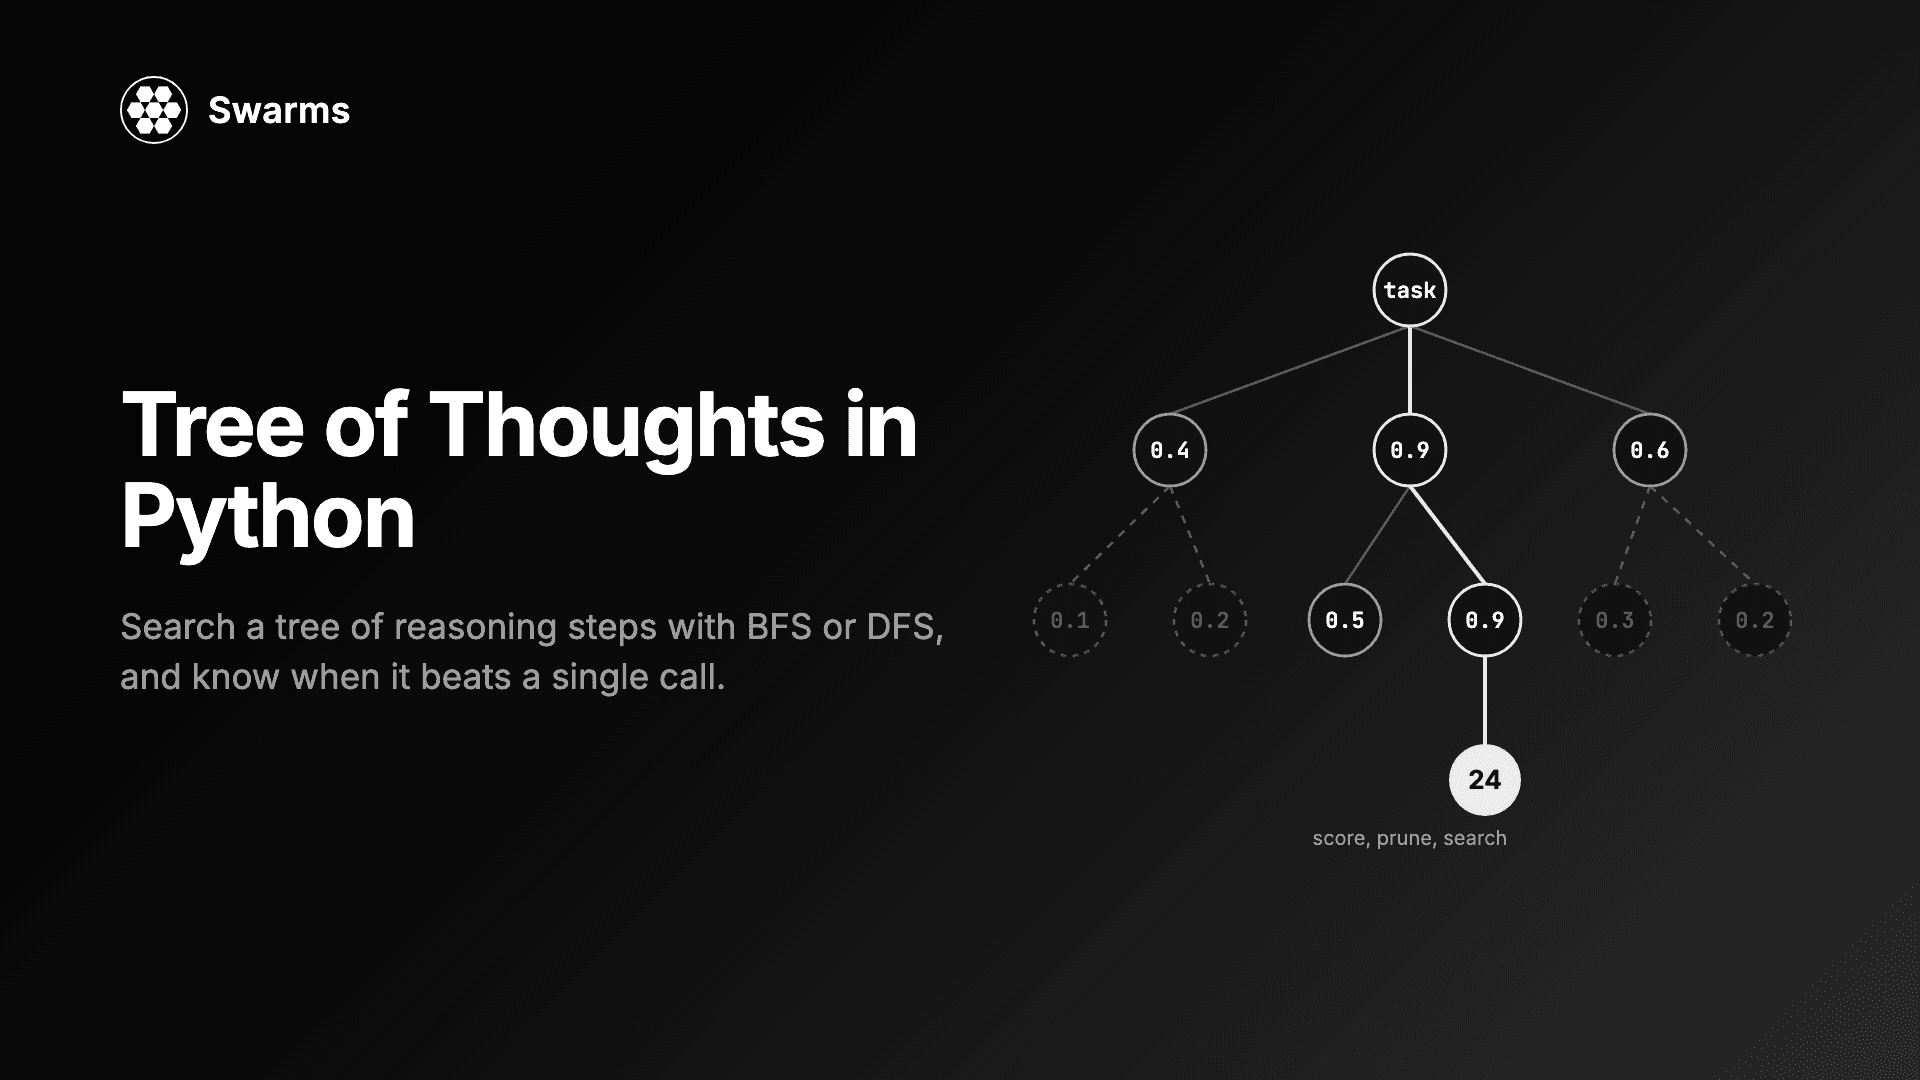
用 Swarms 在 Python 中实现 tree of thoughts:求解 24 点游戏,对比 BFS 与 DFS、propose 与 sample、value 与 vote,控制成本,并查看真实的调用次数。
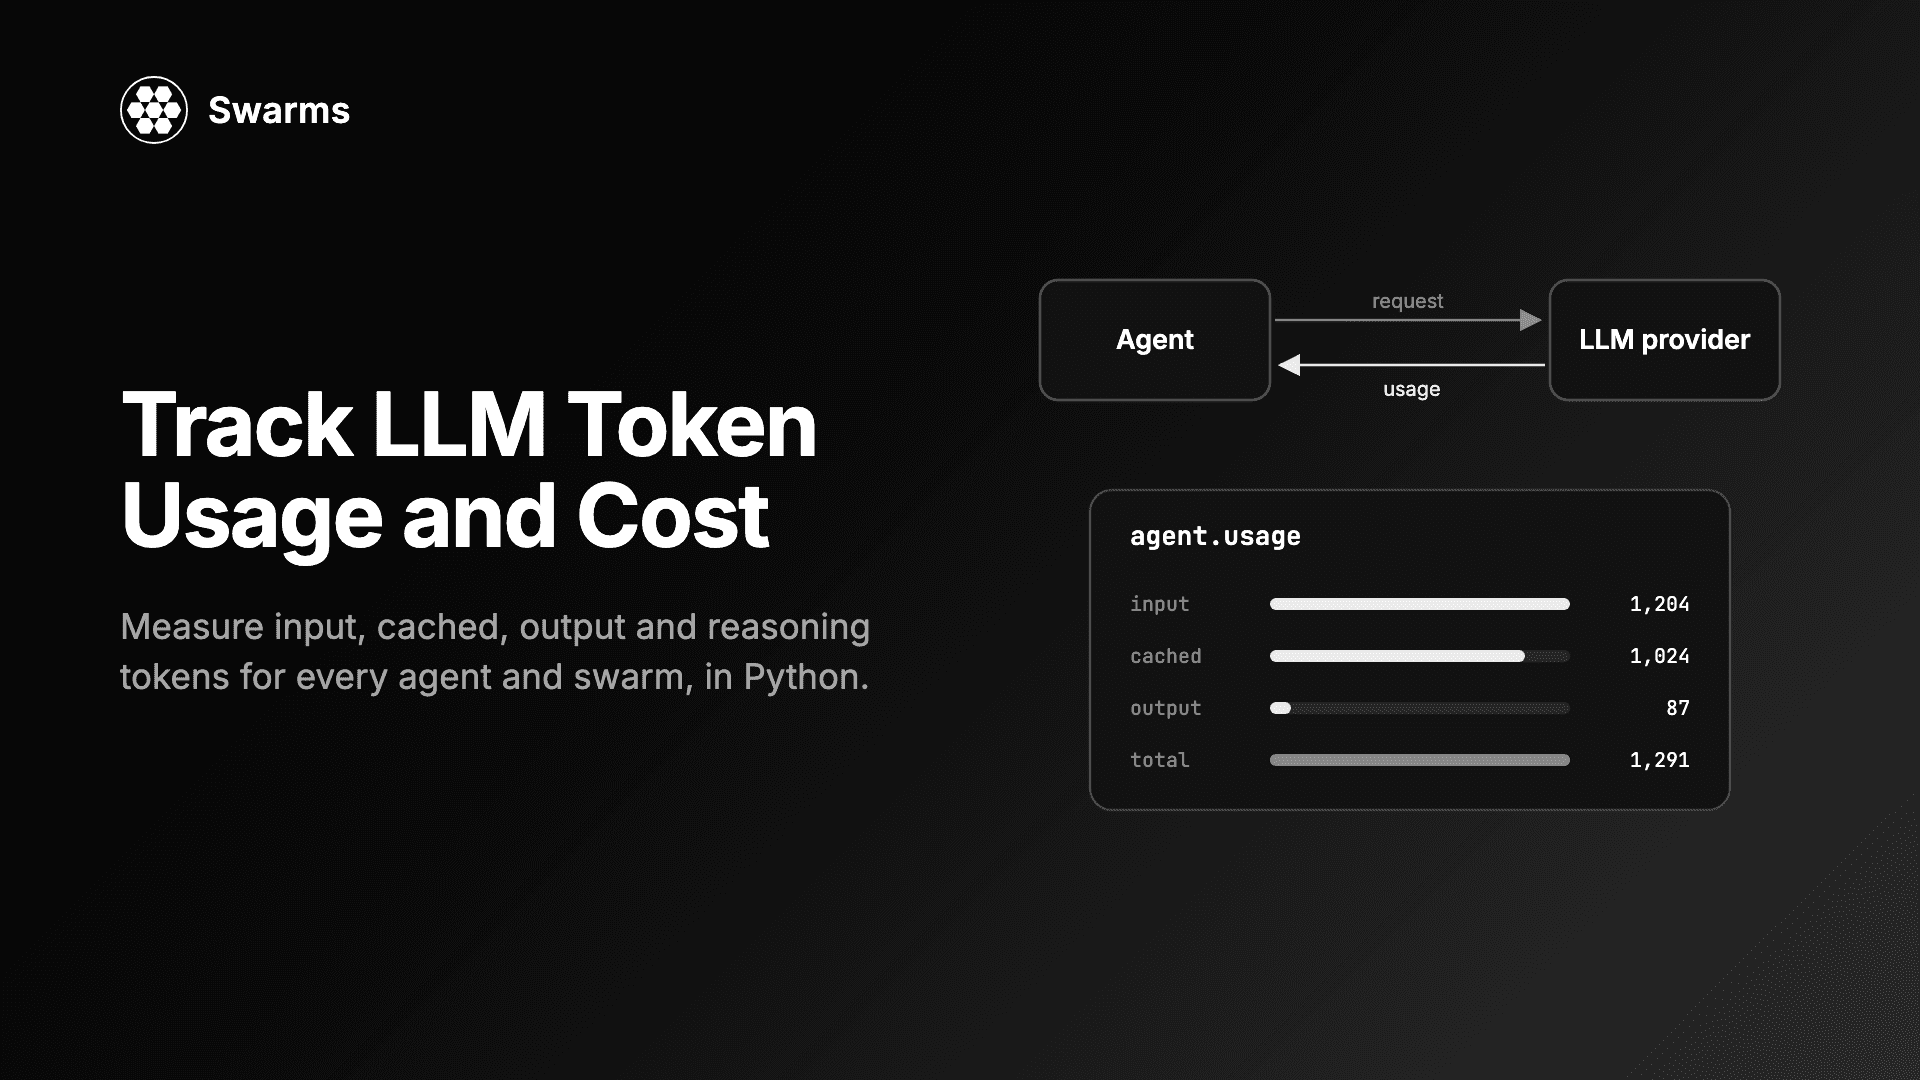
用 Python 追踪每个智能体的 LLM token 用量与成本:输入、输出、缓存与推理 token,单次运行快照,美元成本换算,以及 Swarms 中整个 swarm 的用量合计。