Swarms 研究团队发布了一篇新论文:《AgentRearrange: Simplifying Multi-Agent Workflow Orchestration》,作者为 Kye Gomez、Steve-Dusty、Adi Chaudhary、Ayaan Gazali、Shryuk Grandhi、Wyatt Stanke、Taddy、Vidith Salla、NingLin Liu 和 Nicolas Nahas。论文描述的是开源 Swarms 框架的工作流原语,而核心思想只需一行:
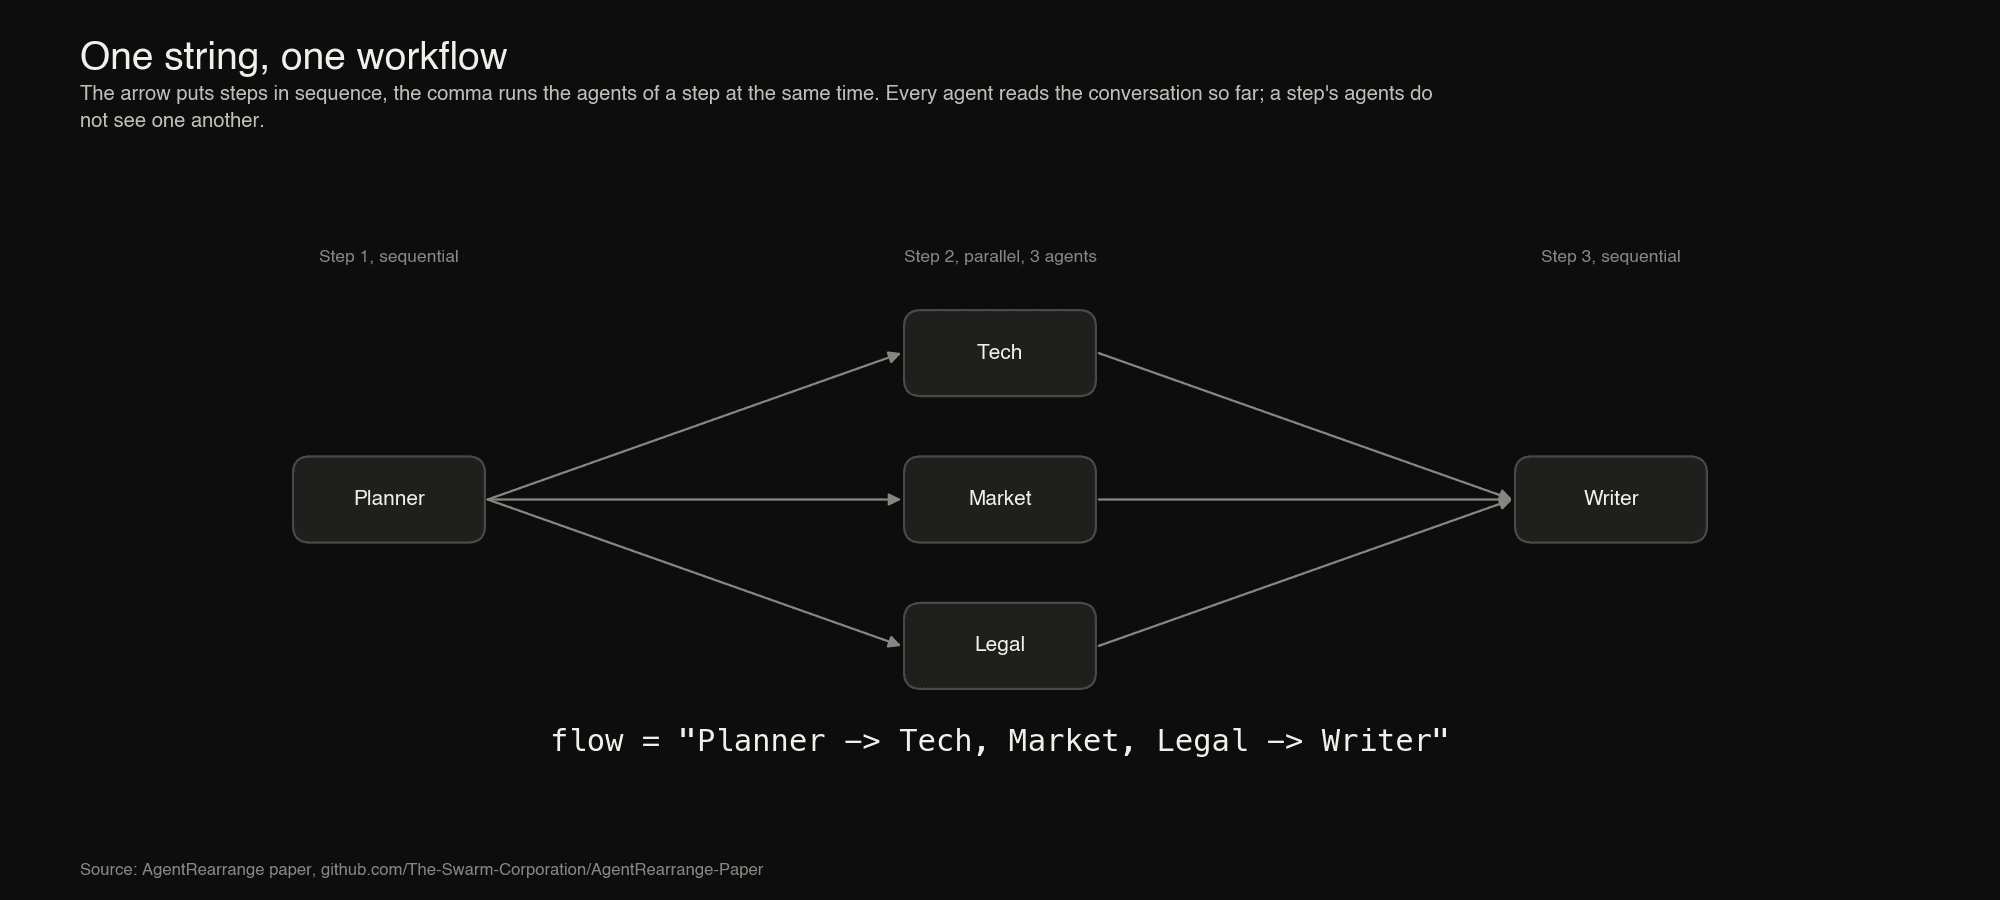
Planner -> Tech, Market, Legal -> Writer
这个字符串就是一个完整的五智能体工作流。箭头让步骤顺序执行,逗号让同一步骤内的智能体同时运行,而智能体本身是只定义一次的普通对象。重新编排团队,就是编辑这个字符串。
论文有四项贡献:流语言精确的语法和执行语义,包括嵌套工作流;同一工作流在六个框架中所需代码的并排对比;一套开放的基准测试套件,用桩模型在 8 到 512 个智能体规模下,把四种工作流形状分别跑过每个框架;以及对这一设计所放弃的东西的直白说明。
核心数字:在宽工作流上,AgentRearrange 在 512 个智能体时增加 37 到 42 毫秒的编排开销,比使用函数节点的 LangGraph 少 2.5 倍,比使用智能体节点的 LangGraph 少约 9 倍,比 LangChain 少 3 倍,比 AutoGen GraphFlow 少两个数量级以上。在这些形状上它拥有所有被测框架中最低的峰值内存,而且更换拓扑比重建并重新编译一张 LangGraph 图快 9 到约 100 倍。在数百个智能体组成的链上,它比每步做常量工作的框架更慢,论文也说明了原因。
本文先逐节解读论文,再展示如何在 Swarms 框架和 Swarms API 中使用 AgentRearrange。
为什么是一个字符串
单个语言模型智能体是围绕模型调用的一个循环。多智能体系统是一组这样的循环,加上一条规则:谁在何时运行,谁能看到谁的输出。多智能体应用的大部分工程工作都花在第二部分,而这也是系统最容易出问题的地方:一项关于多智能体系统失败的研究发现,相当大比例的失败源于系统的规约方式和智能体的协调方式,而非单个智能体本身。
表达这条规则的主流方式是图 API。LangGraph 通过 add_node 和 add_edge 调用构建 StateGraph 并编译;AutoGen 提供 DiGraphBuilder 来喂给 GraphFlow 团队;CrewAI 把智能体绑定到有序的任务列表;Agno 则在 Workflow 内嵌套 Step 和 Parallel 对象。这些 API 很通用,而通用性的代价要在每一个工作流上支付,包括最简单的那些。
论文的出发点是这样一个观察:实践中反复出现的结构模式,无论是每一步都在上一步基础上精炼的链,多个智能体同时处理同一输入的扇出,还是扇出之后再由一步合并结果,都是两种操作的组合:然后 与 同时。两种操作放得进一个字符串。名称和记法沿袭了 einsum 和 einops,它们证明了一个紧凑的字符串可以在不失清晰的前提下替代一整族张量操作调用。
流语言
语法
一个流是由 -> 分隔的非空步骤序列。一个步骤是由逗号分隔的非空名称列表。名称指向在工作流中注册的成员:智能体以其 agent_name 引用,另一个工作流以其 name 引用。名称周围的空白会被忽略。
flow  ::=  step ( "->" step )*
step  ::=  name ( "," name )*
name  ::=  已注册的智能体或嵌套工作流的名称
一个包含 N 个名称、L 个步骤的流,就是一个含 N 个名称、L 减 1 个箭头和 N 减 L 个逗号的字符串。三种特例值得命名:没有逗号的流是链,没有箭头的流是纯扇出,每个步骤都有多个名称的流就是 Mixture-of-Agents 的分层拓扑。
语义
步骤按顺序运行。只有一个名称的步骤运行该成员。有多个名称的步骤同时运行所有成员,并在最后一个完成时结束。每个成员读取到目前为止的对话并把自己的回答追加进去,因此第 k 步的成员能看到任务以及第 1 到第 k 减 1 步的全部回答。同一步骤的成员看不到彼此的回答,而且回答按流中书写的顺序记录,而不是按完成顺序,所以记录是确定性的。把 max_loops 设为 m,整个流会在不断增长的对话上运行 m 次。
用图的语言来说,相邻步骤之间由一组完全二分边相连:第 k 加 1 步的每个成员都依赖第 k 步的每个成员。
| 形状 | 流 | 解析后的步骤 |
|---|
| 链 | a -> b -> c | [[a], [b], [c]] |
| 扇出 | a, b, c | [[a, b, c]] |
| 扇出再扇入 | a -> b, c -> d | [[a], [b, c], [d]] |
| 分层 | a, b -> c, d -> e | [[a, b], [c, d], [e]] |
| 回访 | writer -> critic -> writer | [[writer], [critic], [writer]] |
一个名称可以出现多次,每次出现都是对同一智能体的一次独立调用,回访模式就是这样实现的。
校验与检视
流在工作流构造时、被替换时以及每次运行前都会被检查。检查会拒绝空流、空步骤(例如 "a -> -> b" 中的那个)以及任何未注册的名称,并抛出指明出错步骤或智能体的 ValueError。在确认流格式正确之前,不会发起任何模型调用。
explain 方法打印解析后的计划而不运行任何东西,这让流可以在持续集成中被测试:
>>> workflow.explain()
Flow: Planner -> Tech, Market, Legal -> Writer

Step 1: Planner              [sequential]
Step 2: Tech, Market, Legal  [parallel, 3 agents]
Step 3: Writer               [sequential]

3 steps, 5 agent invocations across 1 loop(s).
嵌套
任何拥有 name 和 run 方法的对象都可以注册为成员,包括另一个 AgentRearrange。嵌套的工作流在外层流中是一个名称,作为一个步骤运行。这让语言在组合下封闭:并行分支可以是一条链,链中的一步可以是一次扇出,任意深度。
experts = AgentRearrange(
    name="Experts",
    agents=[tech, market, legal],
    flow="Tech -> Market, Legal",
)
workflow = AgentRearrange(
    agents=[planner, experts, writer],
    flow="Planner -> Experts -> Writer",
)
以这种方式能表达的序关系是串并联序:由单个智能体出发,反复把两个工作流串联或并联而得到的全部结构。这个类之外最小的依赖结构是"N"形:c 依赖 a 和 b,而 d 只依赖 b。AgentRearrange 无法精确表达它,只能让 d 也等待 a 来做过度近似。对于一般的有向无环图,Swarms 提供 GraphWorkflow。
一次运行如何执行
一个共享对话。 一个 AgentRearrange 持有单一对话。一次运行会重置它,记录任务,然后执行各步骤。成员运行前,对话会为该成员渲染成聊天消息:成员自己之前的回答带 assistant 角色,其余内容作为输入;最新的一轮成为该成员的任务。成员返回后,只有它的回答会被追加,私有的草稿不会。开发者从不需要编写把输出从一个智能体搬到下一个的代码,而这正是流水线语言留给用户去写的那部分。
位置感知。 顺序步骤中的成员会被告知流中紧邻其前后的成员是谁,以系统消息的形式传入,不写入共享对话。开启 team_awareness=True 后,完整的步骤结构会在运行开始时写入对话一次。
并行步骤。 并行步骤的成员在一个按步骤大小分配的线程池上运行。每个成员拿到的是步骤开始时对话状态的独立渲染。所有成员完成后,结果按流中的顺序写回。任一成员抛出的异常会传播给调用方。
输出。 output_type 参数决定 run 从对话中返回什么:完整记录(字符串或列表)、字典,或仅最终回答。
重新编排。 set_custom_flow 替换流。新字符串先经校验,失败时保留旧流并在调用处抛出错误:
workflow.set_custom_flow("Planner -> Tech -> Market -> Legal -> Writer")

workflow.set_custom_flow("Planner -> Tehc -> Writer")
# ValueError: Agent 'Tehc' is not registered.
# workflow.flow 保持不变
智能体不会被重建,也没有任何编译;解析后的步骤按流字符串缓存,字符串变化时刷新。成员也可以用 add_agent 和 remove_agent 增删。
入口。 除了 run,类还提供用于多任务的 batch_run 和 concurrent_run(每个任务在工作流的独立副本上运行,记录不会混淆)、用于事件循环内部的 run_async,以及用于 token 流式输出的 run_stream 和 arun_stream,其中并行步骤各成员的 token 交错到达并按智能体标注。同样的流字符串也被 swarm_type="AgentRearrange" 的 SwarmRouter 和 Swarms API 接受,后文会回到这一点。
同一工作流在六个框架中
论文用多个框架写同一个工作流:一个规划者,三个并行工作的专家,以及一个读取三者输出的撰写者。智能体的构造在各框架中大同小异,只在 AgentRearrange 中展示;对比的是陈述拓扑的那部分代码。
from swarms import Agent, AgentRearrange

planner = Agent(agent_name="Planner", model_name="gpt-5.4", max_loops=1)
tech    = Agent(agent_name="Tech",    model_name="gpt-5.4", max_loops=1)
market  = Agent(agent_name="Market",  model_name="gpt-5.4", max_loops=1)
legal   = Agent(agent_name="Legal",   model_name="gpt-5.4", max_loops=1)
writer  = Agent(agent_name="Writer",  model_name="gpt-5.4", max_loops=1)

workflow = AgentRearrange(
    agents=[planner, tech, market, legal, writer],
    flow="Planner -> Tech, Market, Legal -> Writer",
)
report = workflow.run("Assess launching a payments product in the EU.")
同样的拓扑在 LangGraph 中:
from langgraph.graph import END, START, MessagesState, StateGraph

graph = StateGraph(MessagesState)
graph.add_node("Planner", planner)
graph.add_node("Tech", tech)
graph.add_node("Market", market)
graph.add_node("Legal", legal)
graph.add_node("Writer", writer)
graph.add_edge(START, "Planner")
graph.add_edge("Planner", "Tech")
graph.add_edge("Planner", "Market")
graph.add_edge("Planner", "Legal")
graph.add_edge(["Tech", "Market", "Legal"], "Writer")
graph.add_edge("Writer", END)
app = graph.compile()
report = app.invoke(
    {"messages": [("user", "Assess launching a payments product in the EU.")]}
)
在 AutoGen GraphFlow 中:
from autogen_agentchat.teams import DiGraphBuilder, GraphFlow

builder = DiGraphBuilder()
for agent in (planner, tech, market, legal, writer):
    builder.add_node(agent)
for expert in (tech, market, legal):
    builder.add_edge(planner, expert)
    builder.add_edge(expert, writer)
team = GraphFlow(
    participants=builder.get_participants(), graph=builder.build()
)
report = await team.run(task="Assess launching a payments product in the EU.")
论文把计数推广到一般情形。对于 N 个智能体、L 个步骤的流,AgentRearrange 无论规模如何都只需一个字符串。LangGraph 每个智能体约需两次调用。AutoGen 需要为相邻步骤中的每一对智能体添加一条边,随步骤宽度呈二次增长。Agno 和 LangChain 的嵌套对象风格以及 CrewAI 的任务列表介于两者之间。
| 框架 | N 个智能体、L 个步骤的拓扑规约 | 五智能体示例 |
|---|
| AgentRearrange | 一个含 N 个名称的字符串 | 1 |
LangGraph StateGraph | 构造器、N 次 add_node、约 N 次 add_edge、compile | 13 |
AutoGen GraphFlow | 构建器、N 次 add_node、相邻步骤每对智能体一次 add_edge、build、team | 14 |
Agno Workflow | N 个 Step、每个宽步骤一个 Parallel、一个 Workflow | 7 |
| LangChain LCEL | L 个并行映射、L 个合并步骤、一个序列,外加用户自写的合并函数 | 7 |
CrewAI Crew | N 个带 context 列表的 Task、一个 Crew | 6 |
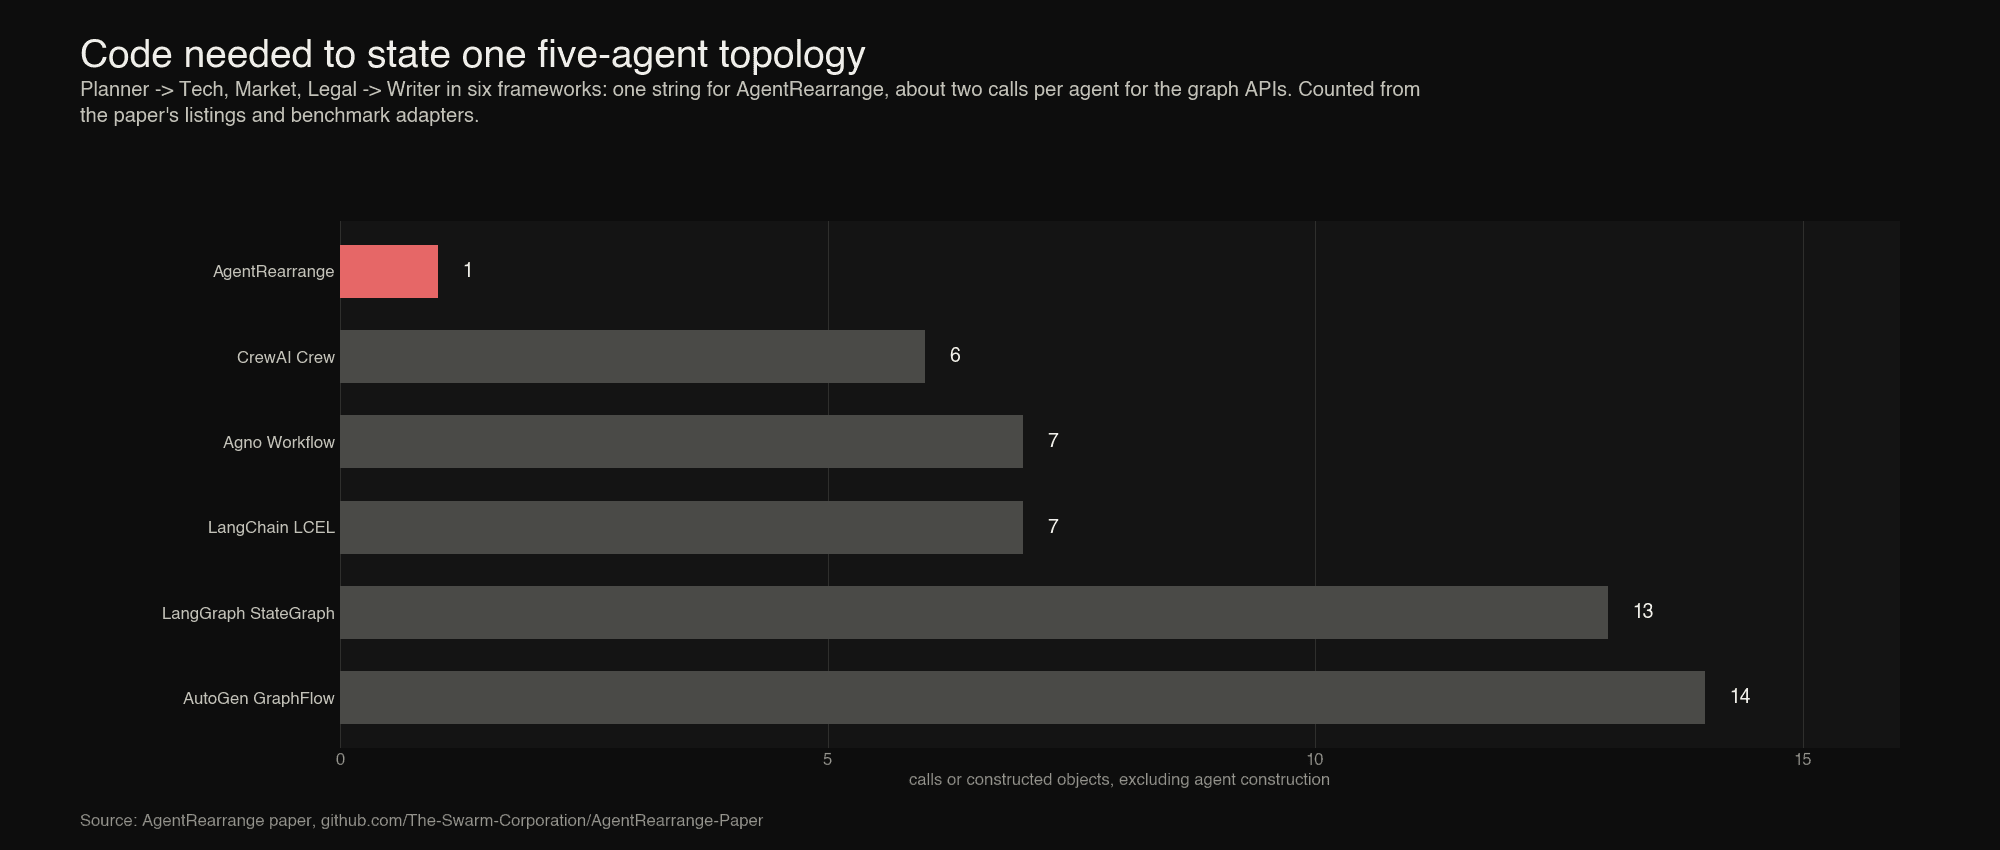
计数还低估了一个差别。在图 API 中,拓扑分散在多条必须相互一致的语句里:边中用到的节点名必须与先前添加的节点匹配,移动一个智能体意味着找到并修改所有触及它的边。在 AgentRearrange 中,拓扑是一个值。它可以存进配置文件,由模型生成,用 == 比较,并以一行 diff 展示给审阅者。
基准测试
Swarms 仓库原本就有一个测量平面扇出的框架基准。本文引入的套件把它扩展到了有结构的工作流。
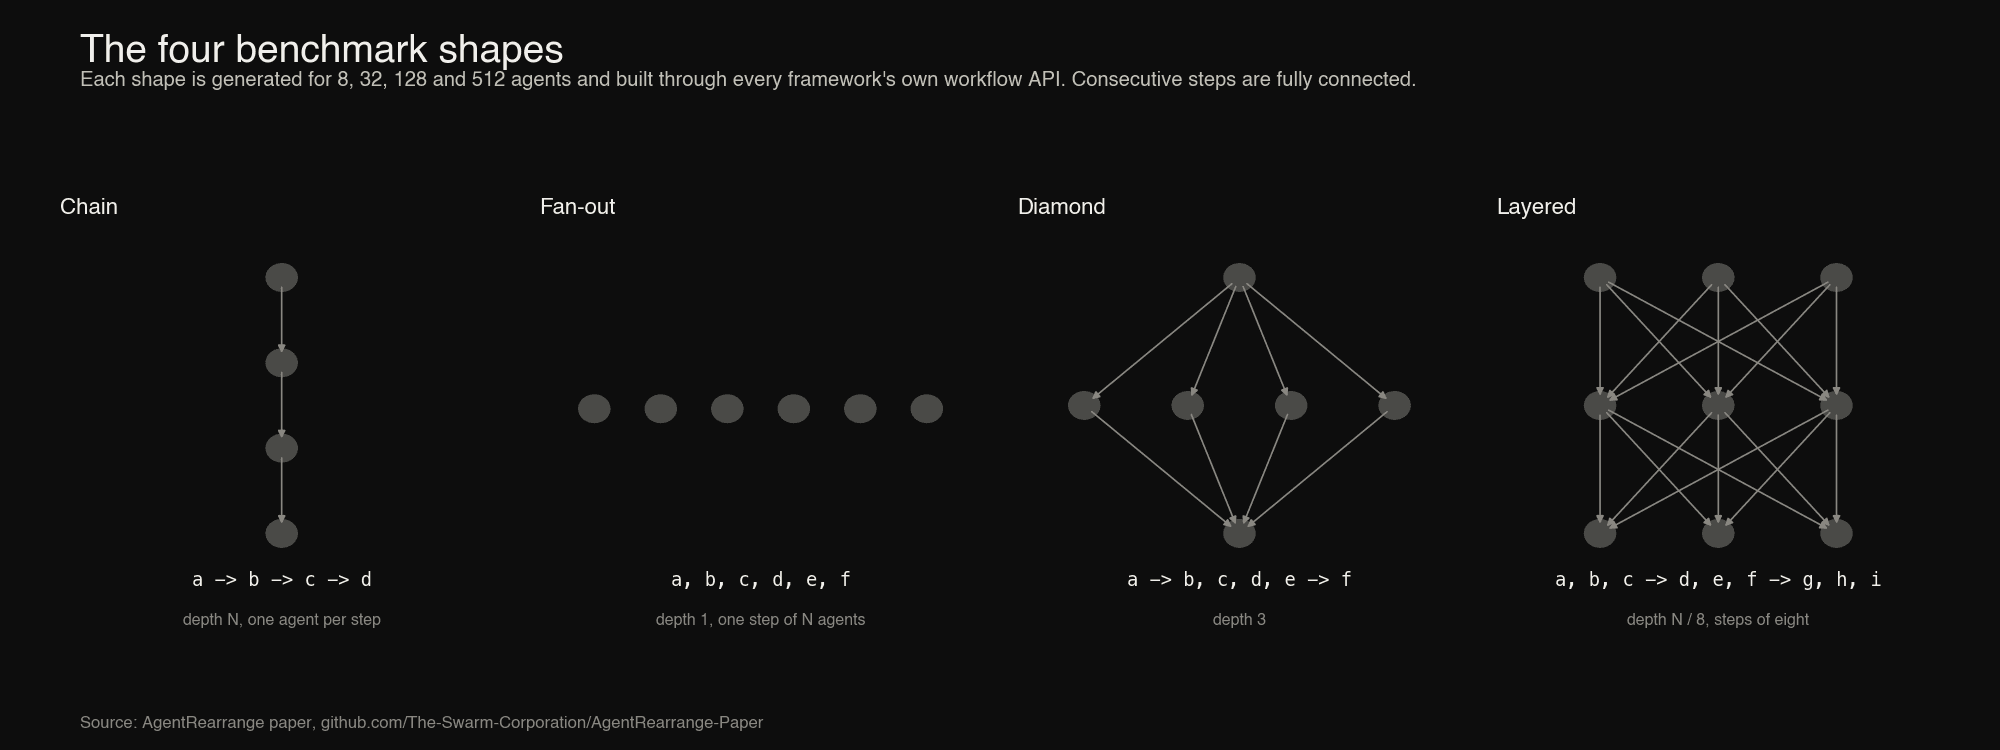
四种形状,每种在 N 为 8、32、128、512 时生成:
- 链:N 个单智能体步骤。深度 N。
- 扇出:一个含 N 个智能体的步骤。深度 1。
- 菱形:一个智能体,然后 N 减 2 个智能体并行,然后一个智能体。深度 3。
- 分层:每步八个智能体,每步读取前一步。深度 N 除以 8。
七种配置。 每种形状都通过各框架自己的工作流 API 构建:Swarms 17 中的 AgentRearrange、LangGraph 0.5.4 的 StateGraph、LangChain Core 0.3.63 的表达式语言、AutoGen AgentChat 0.7.5 的 GraphFlow、Agno 3.2.0 的 Workflow 和 CrewAI 1.15.40 的 Crew。LangGraph 出现两次,因为它的节点既可以是普通函数也可以是智能体,二者成本差异很大。LangGraph (functions) 每个节点用一个调用模型并追加到列表的函数,这是 LangGraph 能运行的最轻的图。LangGraph (agents) 每个节点用一个基于共享消息状态的预构建智能体,更接近 AgentRearrange 实际运行的东西。顺序执行的 CrewAI crew 不能以多个异步任务结尾,因此无法表达扇出和分层形状,这些单元格为空。
桩模型。 每个框架中的每个智能体都通过框架自己的模型接口调用同一个桩:等待 10 毫秒并返回固定字符串。不涉及网络,因此测得的差异全是框架自身的工作。
指标。 每个单元格(框架、形状、规模)在一次小的预热工作流之后,于全新解释器中运行。编排开销 是一次运行的墙钟时间减去该次运行的模型时间,其中一个步骤的模型时间取其最快调用的耗时,一次运行的模型时间是各步骤之和;剩下的就是框架在等待模型之外花掉的时间。套件还记录峰值追踪内存、智能体和工作流的构造时间、把现有智能体集合换成另一拓扑再换回来的重规约时间、峰值线程数,以及模型调用次数,用来核对每个框架恰好发起了 N 次调用,结果全部如此。所有测量来自同一台机器:Apple M3 Pro,12 核,18 GB,macOS 15.7,Python 3.12.3。
结果:编排开销
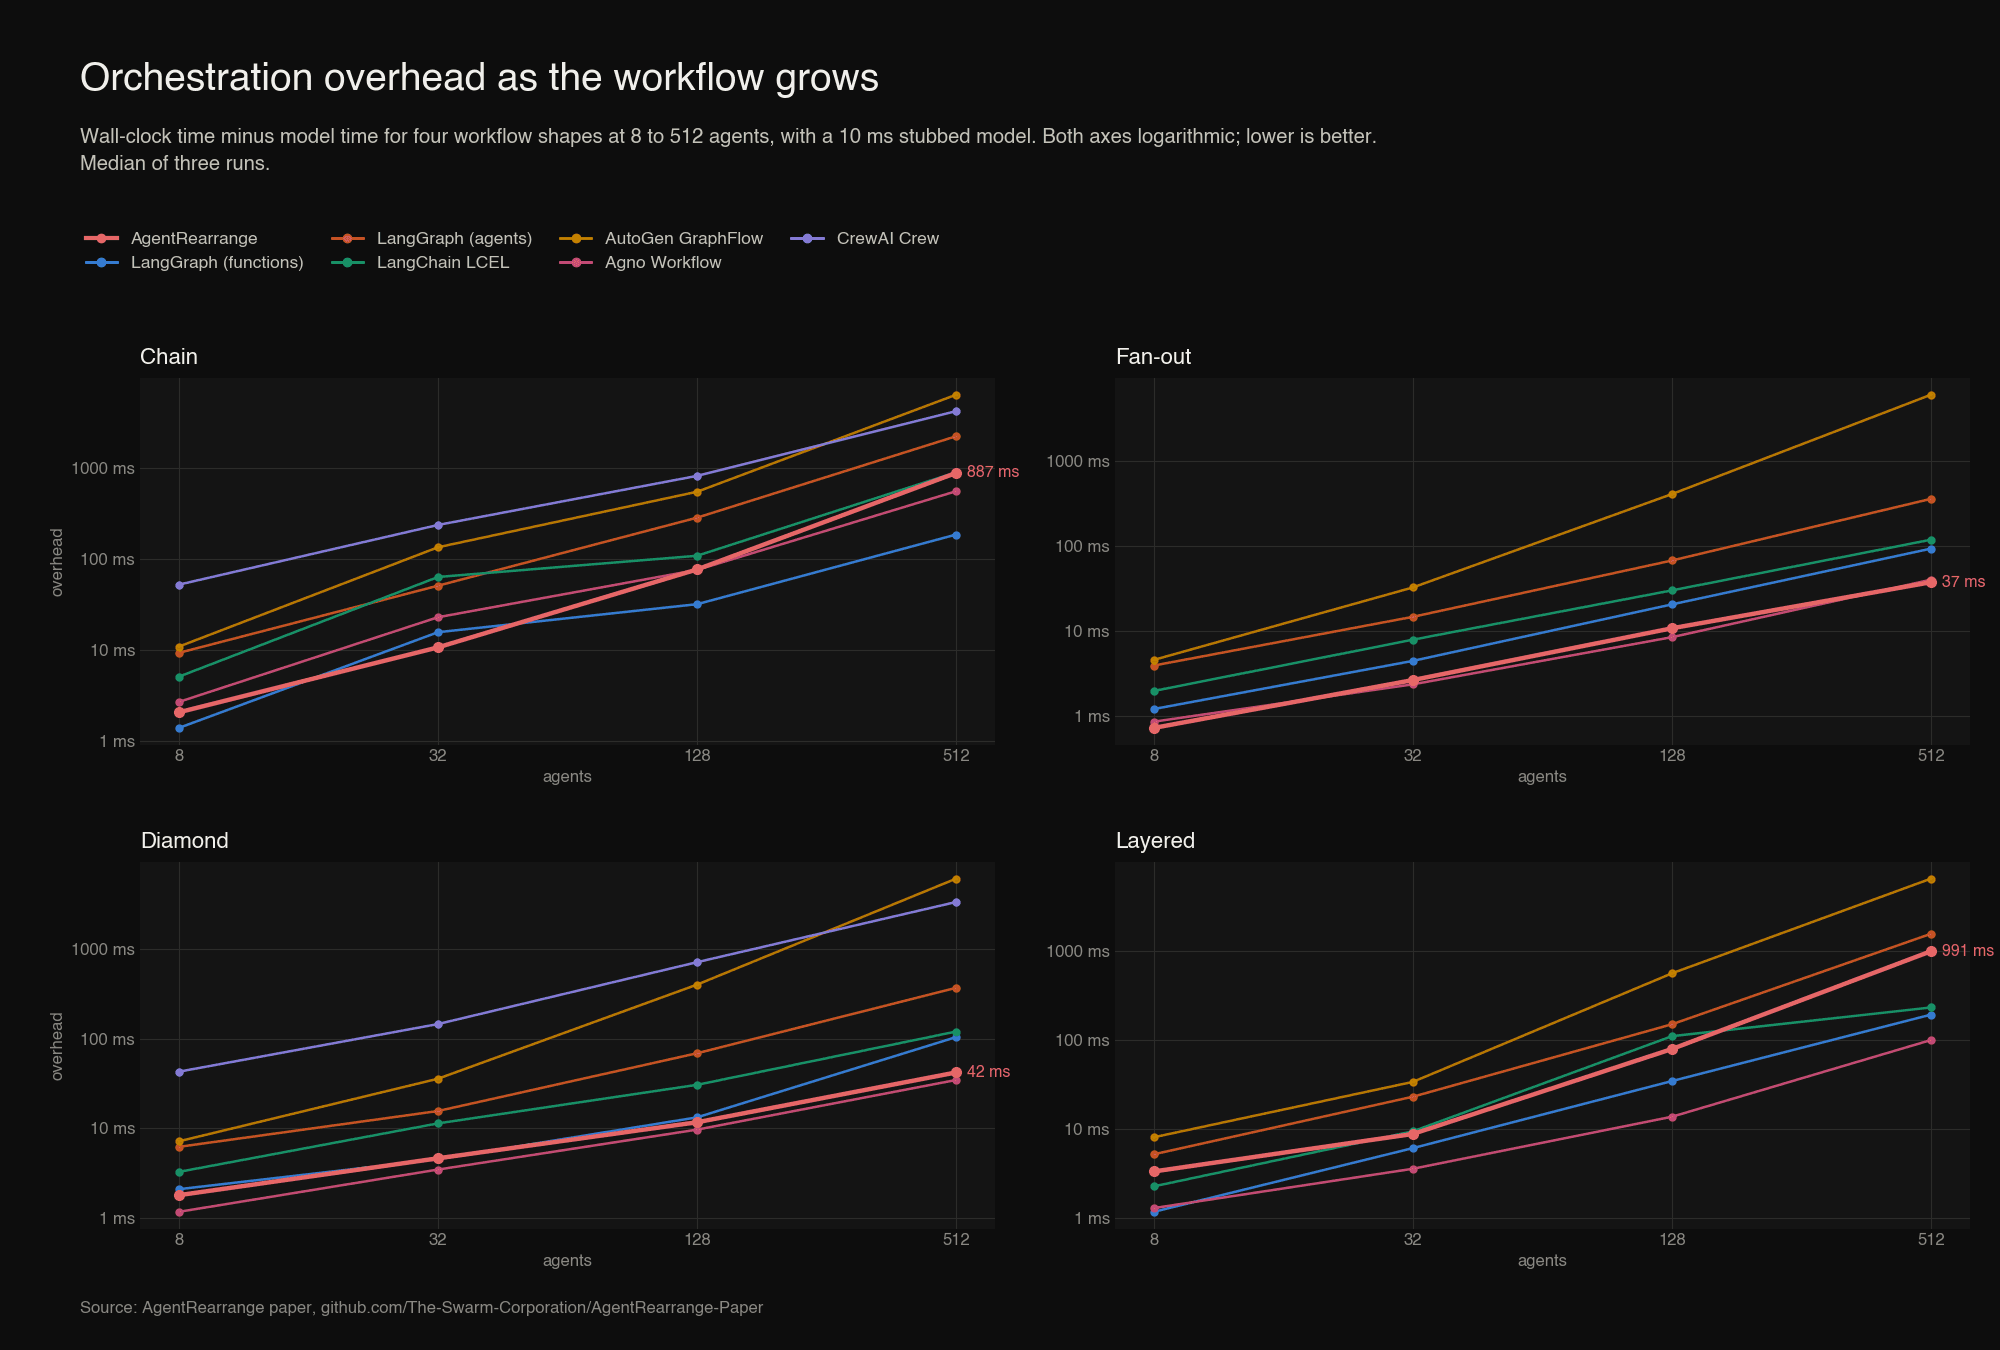
512 个智能体时的开销,单位毫秒,三次运行的中位数。粗体标出每列最低值。
| 链 | 扇出 | 菱形 | 分层 |
|---|
| AgentRearrange | 887 | 37.1 | 42.1 | 991 |
| LangGraph (functions) | 186 | 92.3 | 105 | 192 |
| LangGraph (agents) | 2,246 | 355 | 372 | 1,556 |
| LangChain LCEL | 901 | 117 | 121 | 231 |
| AutoGen GraphFlow | 6,432 | 5,970 | 6,174 | 6,486 |
| Agno Workflow | 558 | 39.7 | 34.7 | 99.6 |
| CrewAI Crew | 4,240 | 不适用 | 3,380 | 不适用 |
三个结果最为突出。
宽工作流扩展良好。 在扇出和菱形形状上,AgentRearrange 在 512 个智能体时增加 37 毫秒和 42 毫秒,每个智能体不到十分之一毫秒。这比使用函数节点的 LangGraph(92 和 105 毫秒)少 2.5 倍,比使用智能体节点的 LangGraph(355 和 372 毫秒)少约 9 倍,比 LangChain 少 3 倍,比 AutoGen GraphFlow 少两个数量级以上,后者的开销超线性增长,达到六秒。只有 Agno 处在同一区间,在菱形上略低,在扇出上略高。在每一个规模上,AgentRearrange 在这两种形状上都与最低开销相差不超过 8 毫秒。
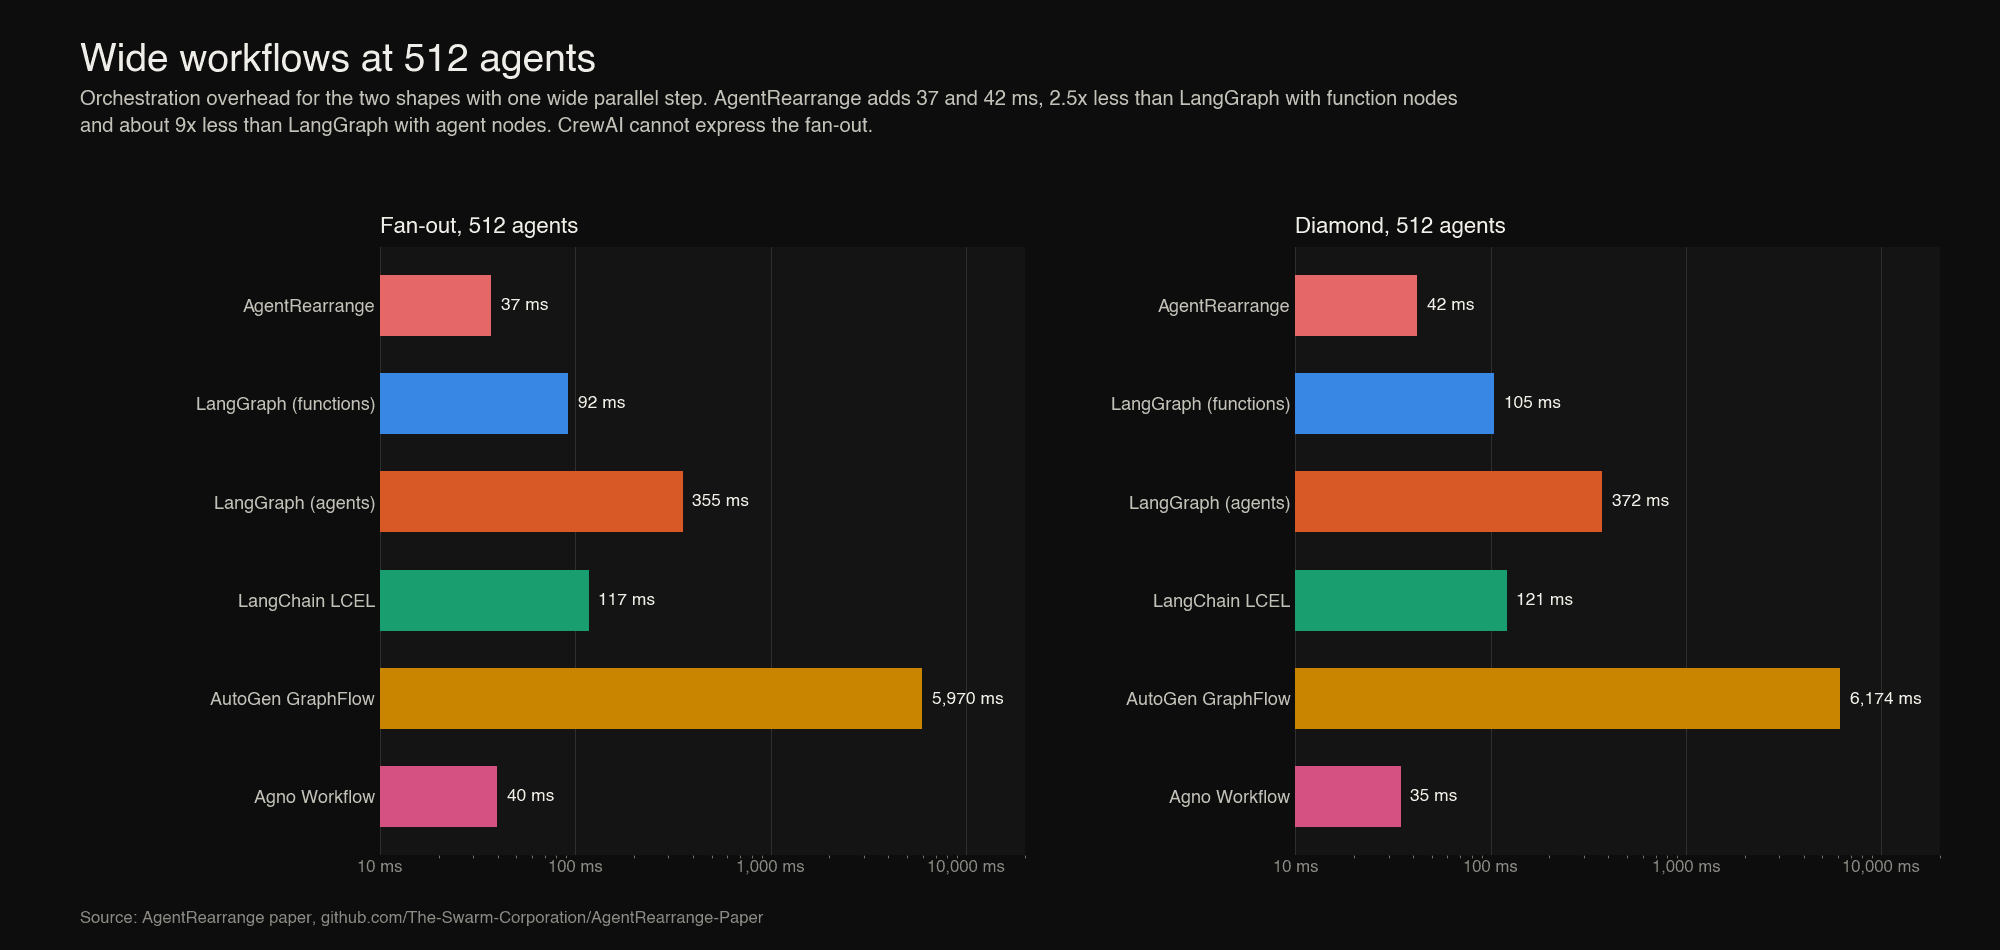
面对节点为智能体的图框架,AgentRearrange 处处更低。 在 LangGraph (agents)、AutoGen GraphFlow 和 CrewAI 能运行的每一个单元格里,跨越全部四种形状和四种规模,它的开销都更低。相对 LangGraph (agents) 的优势从 1.6 倍(分层,512 个智能体)到 9.6 倍(扇出,512 个智能体)。
深工作流暴露了共享对话的成本。 链和分层形状在大规模下讲的是另一个故事。到 32 个智能体为止,AgentRearrange 在每种形状上都是最低或与最低相差不超过 6 毫秒。从 128 个智能体起,它在深工作流中的开销超线性增长:512 智能体的链为 887 毫秒,64 层共 512 个智能体为 991 毫秒,而 LangGraph (functions) 为 186 和 192 毫秒。原因在于执行模型。每个智能体运行前,整个对话都要为它渲染成消息,因此第 k 步做的工作与 k 成正比,一次运行的工作量与深度的平方成正比。一个只向列表追加一项的 LangGraph 函数节点每步做常量工作。同样的效应也出现在其他在智能体间传递历史的框架里:LangGraph (agents) 和 AutoGen 在 512 智能体的链上都比 AgentRearrange 慢,分别为 2.2 秒和 6.4 秒。
论文称这是一笔诚实的交易。换成真实模型,同样的设计会让第 k 步的输入随 k 增长,512 步的链的用户会注意到的是 token 账单,而不是每个智能体 1.7 毫秒的编排开销。这种长度的链本来就不是这门语言的用途。
结果:内存、构造与线程
512 个智能体时的峰值追踪内存,单位 MB:
| 链 | 扇出 | 菱形 | 分层 |
|---|
| AgentRearrange | 52.5 | 5.8 | 5.9 | 52.0 |
| LangGraph (functions) | 2.4 | 6.5 | 6.9 | 6.1 |
| LangGraph (agents) | 8.4 | 12.5 | 13.1 | 13.0 |
| LangChain LCEL | 5.7 | 7.4 | 7.3 | 5.4 |
| AutoGen GraphFlow | 68.7 | 8.8 | 10.1 | 69.8 |
| Agno Workflow | 5.5 | 9.4 | 9.4 | 5.6 |
| CrewAI Crew | 49.7 | 不适用 | 56.3 | 不适用 |
构造 512 个智能体及其工作流的时间,单位毫秒:
| 链 | 扇出 | 菱形 | 分层 |
|---|
| AgentRearrange | 8 | 8 | 8 | 9 |
| LangGraph (functions) | 49 | 44 | 31 | 42 |
| LangGraph (agents) | 246 | 167 | 171 | 169 |
| LangChain LCEL | 20 | 23 | 27 | 12 |
| AutoGen GraphFlow | 6 | 5 | 17 | 15 |
| Agno Workflow | 6 | 6 | 5 | 7 |
| CrewAI Crew | 29 | 不适用 | 34 | 不适用 |
内存呈现与开销相同的分化。在宽形状上,AgentRearrange 拥有所有被测框架中最低的峰值内存:扇出 5.8 MB,菱形 5.9 MB。在深形状上它的峰值约 52 MB,因为对话每步渲染一次;只有 AutoGen 用得更多,约 69 MB。
构造便宜且线性:用 AgentRearrange 构建 512 个智能体及其工作流约 8 毫秒,每个智能体 16 微秒。AutoGen 和 Agno 在同一区间。LangGraph 使用函数节点需 31 到 49 毫秒,使用智能体节点需 167 到 246 毫秒,因为每个预构建智能体本身就是一张编译过的图。
并行步骤消耗线程。AgentRearrange 为并行步骤的每个智能体开一个线程,LangGraph 和 LangChain 在节点调用同步模型时亦然,套件在 512 智能体的扇出上采样到 324 个线程。AutoGen 和 Agno 全程异步,运行在单线程上。线程是 AgentRearrange 在宽形状上没有领先更多的原因,去掉它们是未来工作的第一项。
结果:重规约
AgentRearrange 这个名字本身是一个主张:改变智能体的编排是廉价的。套件通过把现有智能体集合换成另一形状再换回来测量这一点。对 AgentRearrange 这是 set_custom_flow;对其他框架是围绕同一批智能体重建工作流对象,对 LangGraph 还要重新编译。
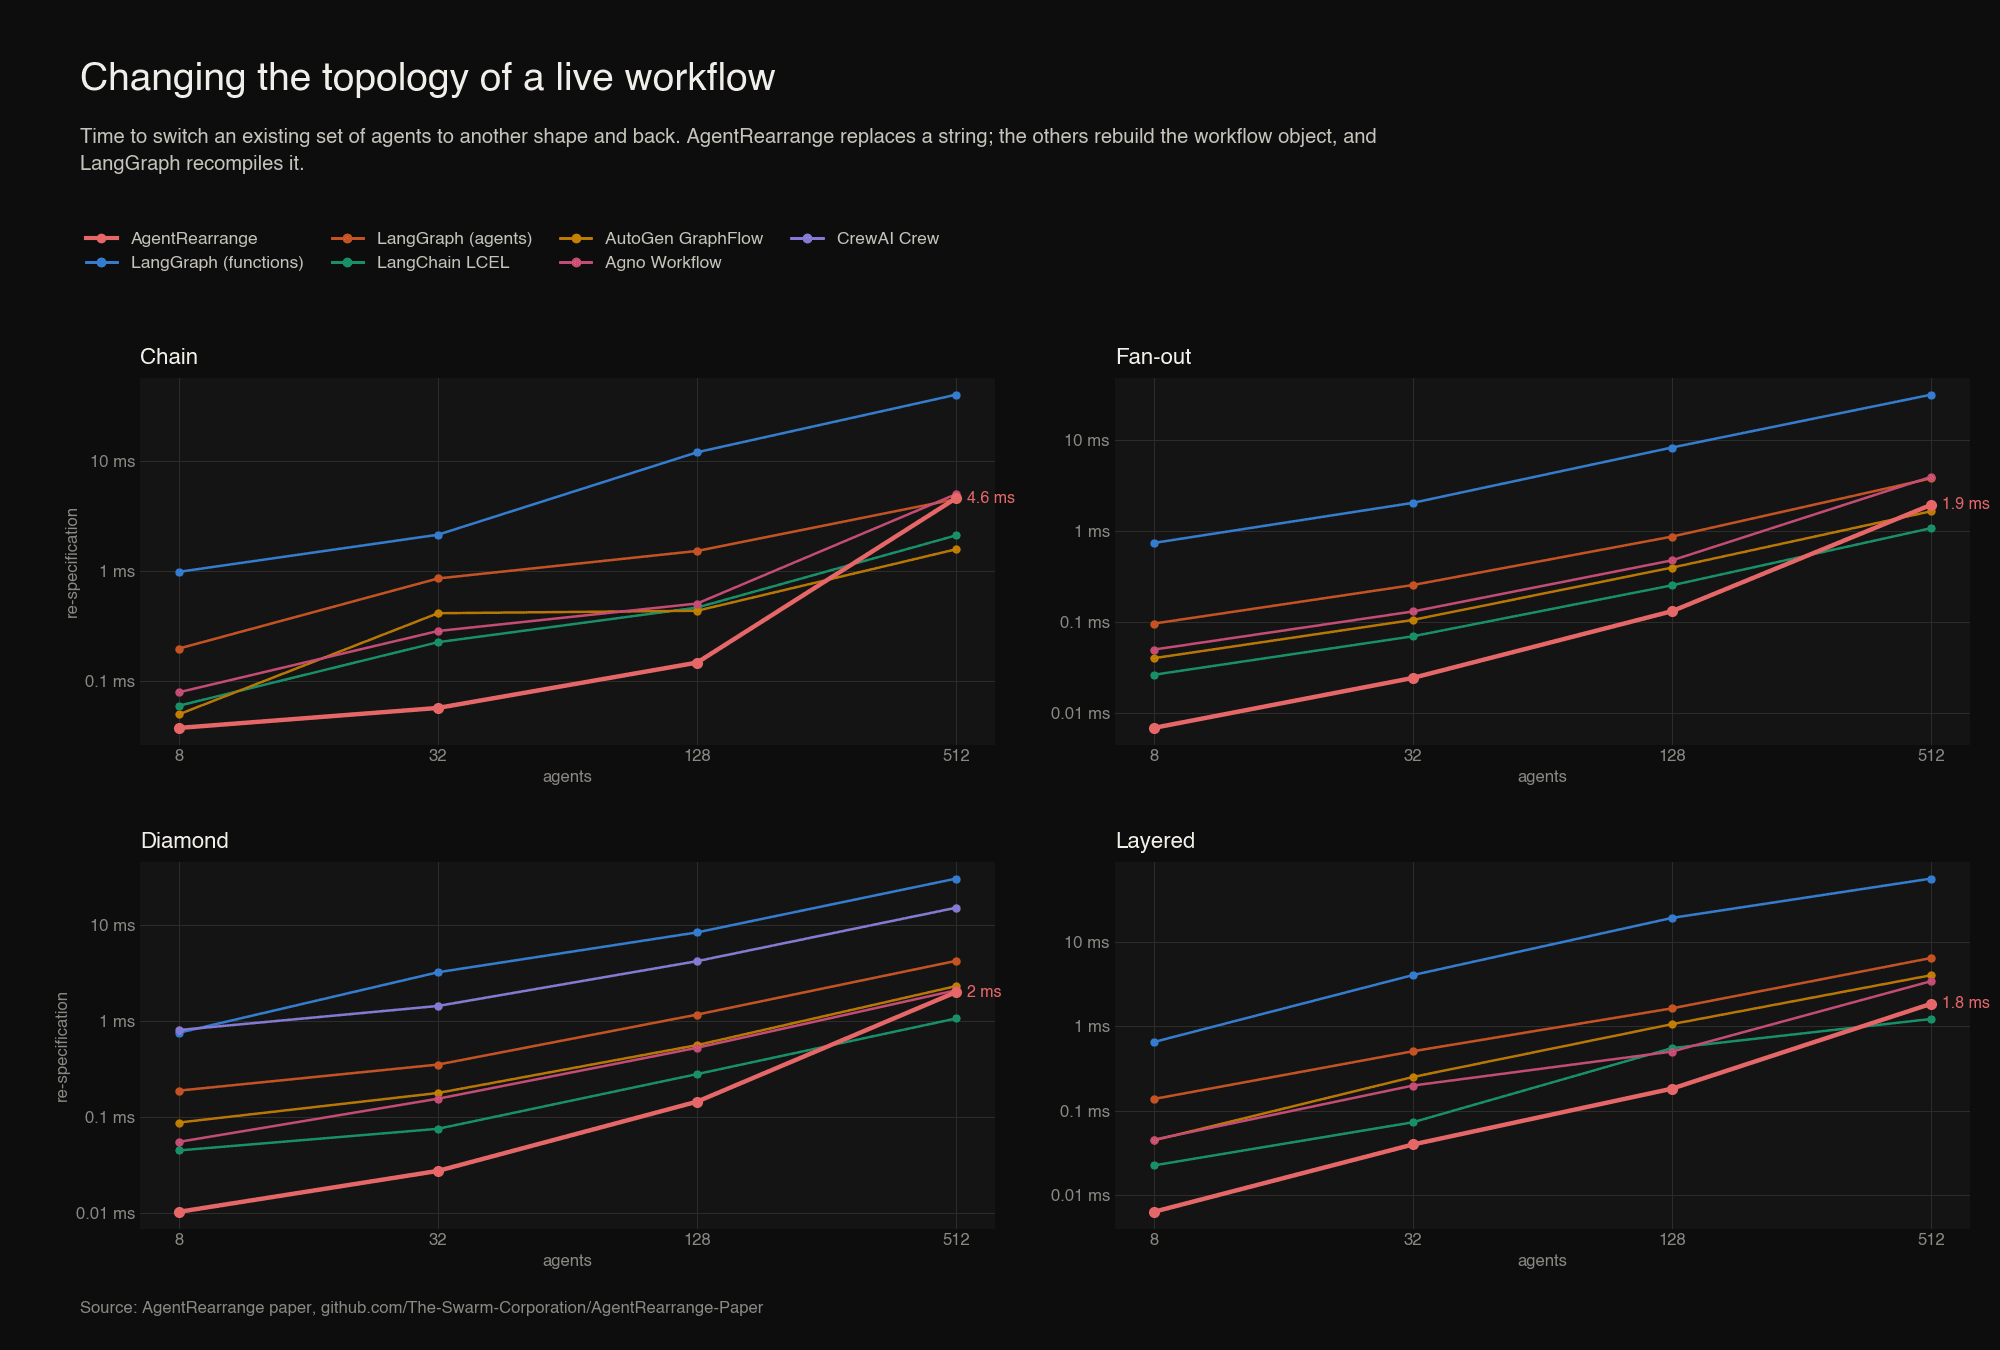
到 128 个智能体为止,AgentRearrange 在每种形状上都是最快的框架:替换 128 智能体工作流的流耗时 0.13 到 0.18 毫秒,而重建并重新编译使用函数节点的 LangGraph 图需 8 到 19 毫秒,相差 58 到 105 倍。在 512 个智能体时,AgentRearrange 需 1.8 到 4.6 毫秒,LangGraph 需 30 到 56 毫秒,相差 9 到 30 倍;但 LangChain 和 AutoGen 的构建器不做任何校验,在这个规模上比 AgentRearrange 快最多三倍。原因在曲线上清晰可见:AgentRearrange 通过扫描成员列表校验新流中的每个名称,这与智能体数量成二次关系,只在这种规模下才显现。
512 个智能体时的重规约时间,单位毫秒:
| 链 | 扇出 | 菱形 | 分层 |
|---|
| AgentRearrange | 4.61 | 1.93 | 1.99 | 1.85 |
| LangGraph (functions) | 40.21 | 31.21 | 30.27 | 56.02 |
| LangGraph (agents) | 4.52 | 3.76 | 4.20 | 6.44 |
| LangChain LCEL | 2.12 | 1.07 | 1.06 | 1.22 |
| AutoGen GraphFlow | 1.58 | 1.64 | 2.29 | 4.03 |
| Agno Workflow | 5.02 | 3.92 | 2.08 | 3.42 |
| CrewAI Crew | 不适用 | 不适用 | 15.04 | 不适用 |
从绝对值看,所有这些时间相对一次模型调用都很小。实际的差别在于这个操作是什么:在 AgentRearrange 中,它是对一个活动对象的一次经校验的赋值;在图框架中,它是对工作流的第二次构造。
背景:平面扇出基准
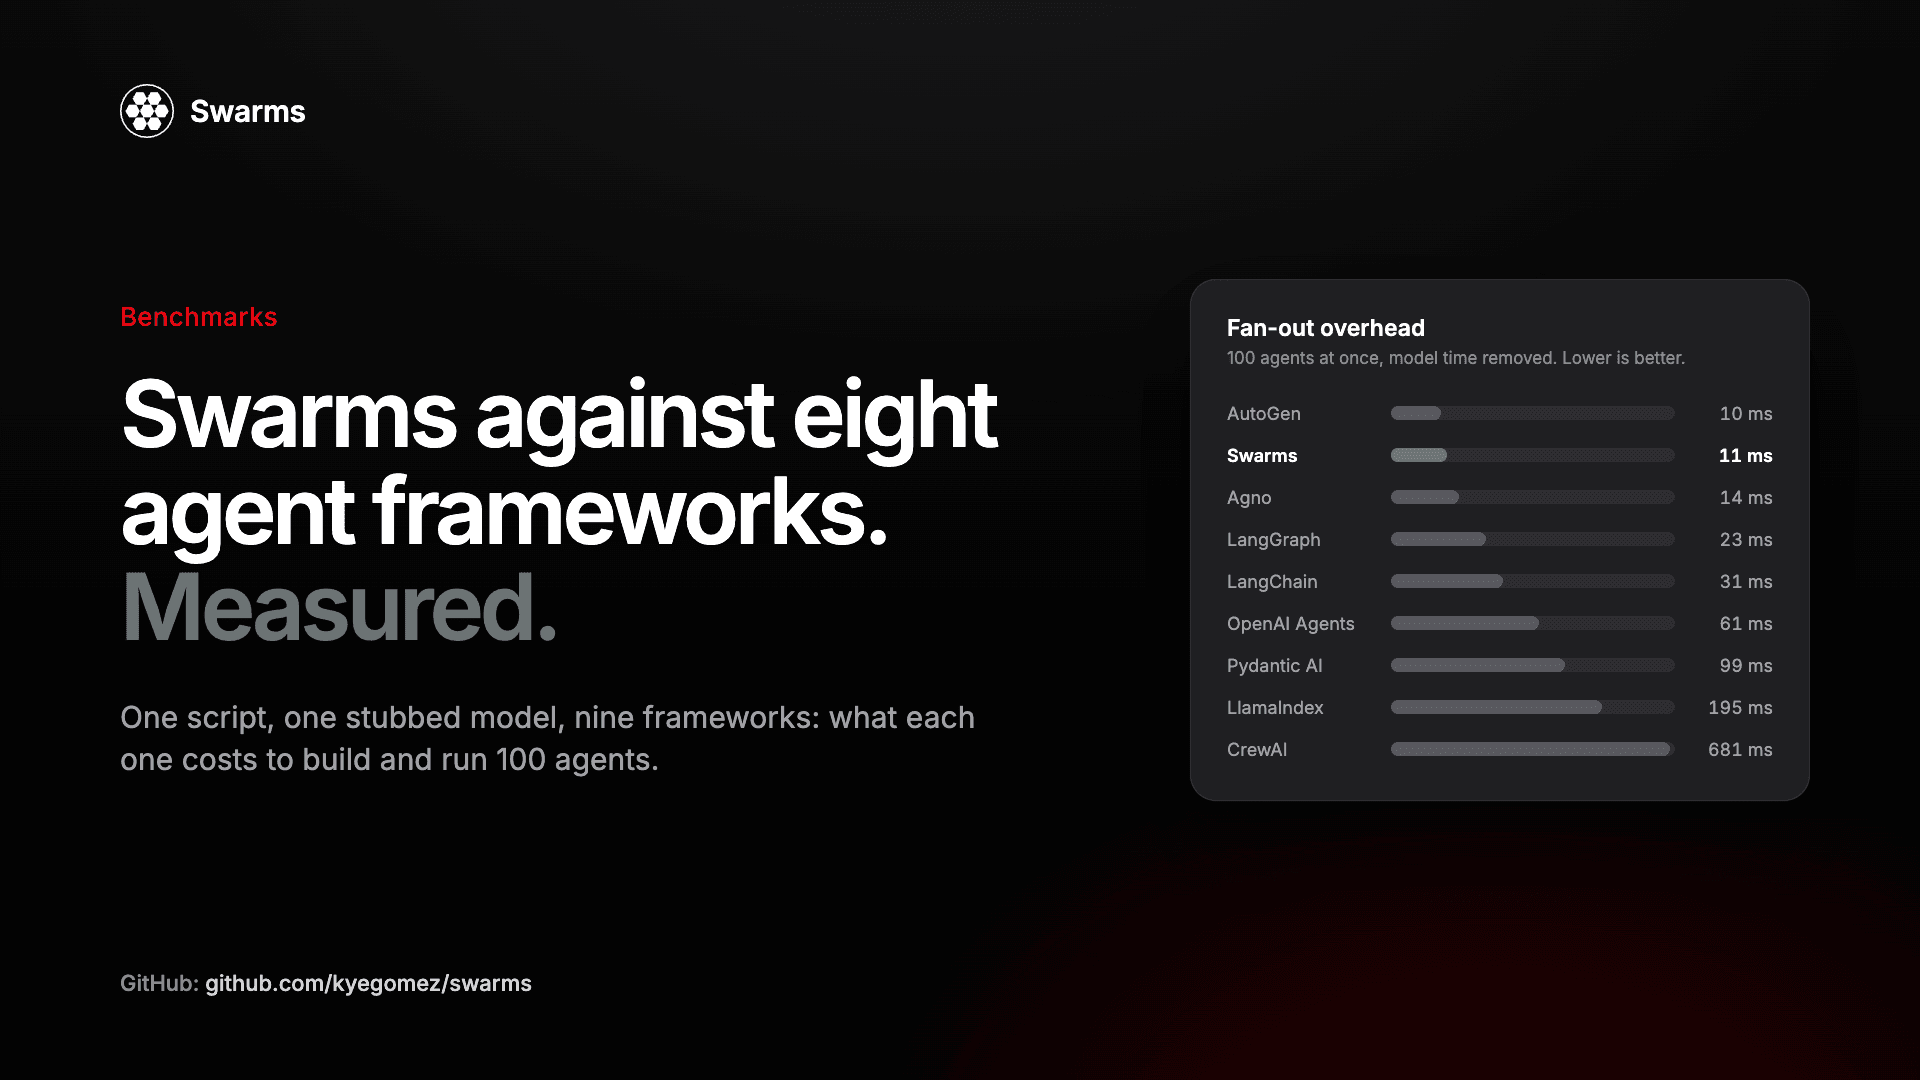
作为参照,论文复现了 Swarms 原有的基准:用 200 毫秒的桩模型,让完整智能体的平面扇出跑过九个框架,其中三个没有工作流层,由 asyncio.gather 驱动。它的 Swarms 列测的是 ConcurrentWorkflow 而非 AgentRearrange,展示的是 AgentRearrange 所编排的智能体底座处在什么位置:开销最低或第二低,智能体对象则属于最重的一类。100 智能体行是三次运行的中位数,1,000 智能体行是单次运行。我们在 Swarms 对比八个智能体框架一文中详细讲过这个基准。
| 框架 | 开销,100 个智能体(毫秒) | 开销,1,000 个智能体(毫秒) | 峰值内存,1,000 个智能体(MB) | 每智能体内存(KB) | 冷导入(秒) |
|---|
| Swarms | 6 | 58 | 14.2 | 6.6 | 0.27 |
| LangGraph | 19 | 304 | 18.4 | 3.8 | 0.28 |
| LangChain | 35 | 307 | 18.8 | 6.6 | 0.03 |
| CrewAI | 580 | 8,461 | 111.8 | 5.6 | 1.82 |
| AutoGen | 9 | 51 | 10.0 | 1.8 | 0.23 |
| OpenAI Agents | 73 | 557 | 34.3 | 2.1 | 0.76 |
| Pydantic AI | 110 | 1,239 | 87.9 | 6.2 | 0.39 |
| LlamaIndex | 170 | 2,334 | 104.0 | 4.0 | 0.65 |
| Agno | 16 | 72 | 16.8 | 3.9 | 0.24 |
字符串放弃了什么
这门语言刻意很小,论文把它省略的东西说得和结果一样直白。流总是运行每一步:没有条件边,没有环,max_loops 是把整个流重复固定次数,而不是循环到某个条件成立。相邻步骤完全连接,所以"某个智能体只需要上一步部分回答"的依赖结构只能过度近似而不能精确陈述;一般的 DAG 由 GraphWorkflow 覆盖。每个成员读取之前写下的一切,这省去了胶水代码,但让 N 个智能体的链的总输入 token 随 N 的平方增长。智能体按名称引用,所以名称在工作流内必须唯一,且不能包含逗号或箭头。宽度为 w 的并行步骤在其持续期间占用 w 个线程。一次运行无法从中途恢复。
三条未来工作的方向直接来自测量结果:像 Swarms 中的 ConcurrentWorkflow 现在那样,在一个事件循环上运行并行步骤;给成员一个有界的对话视图,例如只看上一步;以及对语法做小幅扩展,比如用括号做内联嵌套,让任意深度的串并联工作流仍是一个字符串。论文的讨论章节有完整说明,包括对有效性威胁的分析。
在 Swarms 框架中使用 AgentRearrange
AgentRearrange 随 swarms 包发布。安装它并设置模型提供商的密钥:
pip install -U swarms
export OPENAI_API_KEY="..."
论文中的五智能体工作流,配上简短的系统提示,让每个专家各司其职:
from swarms import Agent, AgentRearrange

planner = Agent(
    agent_name="Planner",
    system_prompt="Turn the task into three to five concrete questions for the specialists.",
    model_name="gpt-5.4",
    max_loops=1,
)
tech = Agent(agent_name="Tech", system_prompt="Answer the technical questions only.", model_name="gpt-5.4", max_loops=1)
market = Agent(agent_name="Market", system_prompt="Answer the market questions only.", model_name="gpt-5.4", max_loops=1)
legal = Agent(agent_name="Legal", system_prompt="Answer the legal and regulatory questions only.", model_name="gpt-5.4", max_loops=1)
writer = Agent(
    agent_name="Writer",
    system_prompt="Write a one-page recommendation from the specialists' answers, citing which specialist each point came from.",
    model_name="gpt-5.4",
    max_loops=1,
)

workflow = AgentRearrange(
    agents=[planner, tech, market, legal, writer],
    flow="Planner -> Tech, Market, Legal -> Writer",
    max_loops=1,
    output_type="final",  # 只返回 Writer 的回答
)

workflow.explain()  # 打印计划,不调用模型
report = workflow.run("Assess launching a payments product in the EU.")
print(report)
同一批智能体换一种编排,只是一次赋值。如果新流有拼写错误,旧流保持不变:
workflow.set_custom_flow("Planner -> Tech -> Market -> Legal -> Writer")  # 一条链
workflow.set_custom_flow("Tech, Market, Legal -> Writer")                 # 跳过规划者
起草、评审、修改的循环,通过把一个智能体命名两次来复用它。开启 team_awareness=True 后,每个智能体都会被告知自己前后是谁:
from swarms import Agent, AgentRearrange

writer = Agent(agent_name="writer", model_name="gpt-5.4", max_loops=1)
reviewer = Agent(agent_name="reviewer", model_name="gpt-5.4", max_loops=1)

revise = AgentRearrange(
    agents=[writer, reviewer],
    flow="writer -> reviewer -> writer",
    max_loops=1,
    team_awareness=True,
)
result = revise.run("Draft, critique, then revise a short essay on Hannah Arendt.")
用一个工作流跑多个任务,以及流式输出:
# 每个任务在工作流的独立副本上运行,记录不会混淆。
reports = workflow.batch_run([
    "Assess launching a payments product in the EU.",
    "Assess launching a payments product in Brazil.",
])

# 并行步骤中各智能体的 token 交错到达,并按智能体标注。
for chunk in workflow.run_stream("Assess launching a payments product in Japan."):
    print(chunk, end="")
流字符串同样被 swarm_type="AgentRearrange" 的 SwarmRouter 接受,因此在运行时选择 swarm 类型的路由器可以把同一批智能体和同一个流直接交给它。
通过 Swarms API 使用 AgentRearrange
如果你不想自己托管智能体,Swarms API 会在托管基础设施上运行同一个原语。swarm 类型为 AgentRearrange,流放在 rearrange_flow 中;流里的名称必须与各智能体的 agent_name 完全一致。在 cloud.swarms.world/api-keys 获取密钥。
把请求保存为 payments_flow.json:
{
  "name": "EU payments launch assessment",
  "description": "Planner first, three specialists in parallel, then a writer",
  "swarm_type": "AgentRearrange",
  "rearrange_flow": "Planner -> Tech, Market, Legal -> Writer",
  "max_loops": 1,
  "task": "Assess launching a payments product in the EU. Keep every answer under 120 words.",
  "agents": [
    {
      "agent_name": "Planner",
      "description": "Breaks the assessment into questions for the specialists",
      "system_prompt": "You turn the task into three to five concrete questions, one line each, for technical, market and legal specialists. No answers.",
      "model_name": "gpt-5.4-mini",
      "max_loops": 1,
      "max_tokens": 400,
      "temperature": 0.3
    },
    {
      "agent_name": "Tech",
      "description": "Answers the technical questions",
      "system_prompt": "You answer only the technical questions in the plan, in under 120 words.",
      "model_name": "gpt-5.4-mini",
      "max_loops": 1,
      "max_tokens": 400,
      "temperature": 0.3
    },
    {
      "agent_name": "Market",
      "description": "Answers the market questions",
      "system_prompt": "You answer only the market questions in the plan, in under 120 words.",
      "model_name": "gpt-5.4-mini",
      "max_loops": 1,
      "max_tokens": 400,
      "temperature": 0.3
    },
    {
      "agent_name": "Legal",
      "description": "Answers the legal and regulatory questions",
      "system_prompt": "You answer only the legal and regulatory questions in the plan, in under 120 words.",
      "model_name": "gpt-5.4-mini",
      "max_loops": 1,
      "max_tokens": 400,
      "temperature": 0.3
    },
    {
      "agent_name": "Writer",
      "description": "Writes the final recommendation from the specialists' answers",
      "system_prompt": "You write a five-sentence recommendation from the specialists' answers. Cite which specialist each point came from.",
      "model_name": "gpt-5.4-mini",
      "max_loops": 1,
      "max_tokens": 500,
      "temperature": 0.3
    }
  ]
}
用 cURL 发送:
curl -X POST "https://api.swarms.world/v1/swarm/completions" \
  -H "x-api-key: $SWARMS_API_KEY" \
  -H "Content-Type: application/json" \
  -d @payments_flow.json
或者用 Python:
import json
import os

import requests

with open("payments_flow.json") as f:
    payload = json.load(f)

response = requests.post(
    "https://api.swarms.world/v1/swarm/completions",
    headers={"x-api-key": os.environ["SWARMS_API_KEY"], "Content-Type": "application/json"},
    json=payload,
    timeout=600,
)
response.raise_for_status()
result = response.json()

for turn in result["output"]:
    print(f"--- {turn['role']} ---")
    print(turn["content"])

print(result["usage"]["total_tokens"], "tokens,", result["usage"]["total_cost"], "USD")
我们在写这篇文章时真实发送了这个请求。响应按流的顺序为每个智能体列出一轮:Planner 在前,三个专家按流中命名的顺序居中,Writer 在后,然后是用量块。节选如下:
{
  "job_id": "swarm-47d9aaf47712ff511d88f087c7f392ce",
  "status": "success",
  "swarm_name": "EU payments launch assessment",
  "swarm_type": "AgentRearrange",
  "output": [
    { "role": "Planner", "content": "1. **Tech:** What architecture, security controls, licensing dependencies, and data localization requirements are needed ..." },
    { "role": "Tech",    "content": "1. Use a PCI-DSS-aligned, API-first, modular architecture with strong segregation of duties ..." },
    { "role": "Market",  "content": "Best near-term EU bets: SMEs/marketplaces/saas needing local bank transfer, cards, and payouts ..." },
    { "role": "Legal",   "content": "For an EU payments product, key legal obligations include: payment services licensing under PSD2 ..." },
    { "role": "Writer",  "content": "From **Tech**, use a PCI-DSS-aligned, API-first, modular setup ... From **Market**, the strongest near-term wedge is SMEs ... From **Legal**, you likely need PSD2 payment services or e-money licensing ..." }
  ],
  "number_of_agents": 5,
  "execution_time": 7.52,
  "usage": {
    "input_tokens": 1211,
    "output_tokens": 736,
    "total_tokens": 1947,
    "total_cost": 0.054853
  }
}
五个智能体,其中三个并行,端到端 7.5 秒,花费约五美分。要重新编排团队,修改 rearrange_flow 再发一次请求即可,智能体定义不用动。要用同一个流跑多个任务,/v1/swarm/batch/completions 批量端点接受这类载荷的列表。
复现这些数字
基准测试套件不需要 API 密钥。克隆论文仓库,安装各框架,然后运行:
git clone https://github.com/The-Swarm-Corporation/AgentRearrange-Paper
cd AgentRearrange-Paper

pip install swarms langgraph langchain-core autogen-agentchat autogen-ext agno crewai
python benchmarks/benchmark_agent_rearrange.py --out results.json
脚本会重新生成上文所有图表背后的每一个测量值。未安装的框架会在其单元格报错,其余照常运行。论文背后的原始数据在 benchmarks/results/scaling_2026-11-13.json,在各框架中构建每种形状的适配器在 benchmarks/equivalents/,论文的单文件 LaTeX 源码用 tectonic paper.tex 即可构建。
结论
AgentRearrange 把多智能体工作流的规约缩减为一个带两个运算符的字符串。这个字符串很短,在任何东西运行前就已校验,可以在活动的工作流上检视和替换,而且借助嵌套覆盖了智能体的每一种串并联编排。基准测试套件表明,在这门语言本该被使用的地方,简洁并没有以速度为代价:对于宽而浅的工作流,AgentRearrange 的编排开销位列被测框架中最低之列,内存最低,并且在每个规模上都比所有以完整智能体为节点的图框架更便宜。同一套件也展示了这个设计在哪里停止扩展:在数百个智能体都读取同一份共享对话的链上,而这一结果直接指向了下一步的改进。对于大多数多智能体系统所由构成的那些工作流,一行文本就够了。
链接与资源