产品工程
RouteHub 发布:极速 LLM 网关
RouteHub 是一个开源 LLM 网关,通过一个 API 连接 20 多家模型提供商,支持流式输出、异步调用和工具调用。它的导入速度比 LiteLLM 快 383 倍,拿到首个响应快 5.5 倍,内存占用少 3.9 倍,每次调用只增加 9 微秒开销,在 Claude 调用和流式输出上比官方 Anthropic SDK 还快。本文介绍它的工作原理、完整的基准测试结果,以及如何上手。
Swarms 团队12 分钟阅读

RouteHub 是一个开源 LLM 网关,通过一个 API 连接 20 多家模型提供商,支持流式输出、异步调用和工具调用。它的导入速度比 LiteLLM 快 383 倍,拿到首个响应快 5.5 倍,内存占用少 3.9 倍,每次调用只增加 9 微秒开销,在 Claude 调用和流式输出上比官方 Anthropic SDK 还快。本文介绍它的工作原理、完整的基准测试结果,以及如何上手。
今天我们正式发布 RouteHub,一个为性能而生的开源 LLM 网关。RouteHub 用一个 completion() 函数把你的应用连接到 20 多家 LLM 提供商:OpenAI、Anthropic、Gemini、Groq、xAI、DeepSeek、OpenRouter、Mistral、Together、Fireworks、Azure OpenAI、Ollama、vLLM,以及任何兼容 OpenAI 的服务。流式输出、异步执行和工具调用都使用同一个函数,每个响应都是官方 OpenAI SDK 自己的 ChatCompletion 类型。
RouteHub 沿用了 LiteLLM 的函数名和模块路径,所以对大多数应用来说,切换过来只需要改一行导入。区别在于网关本身的开销。在我们与 LiteLLM 1.104.0 的对比测试中:
本文介绍网关开销为什么对智能体很重要、RouteHub 如何把开销压到最低、基准测试的结果(包括 RouteHub 目前还不占优的地方),以及如何上手。RouteHub 采用 Apache 2.0 许可证,支持 Python 3.10 及以上版本,现已在 PyPI 上发布。
LLM 网关位于应用每一次请求的关键路径上。对单条聊天消息来说,它的开销和模型生成 token 所花的几秒钟相比微不足道。但智能体工作负载会从三个方面放大这部分开销:
我们在构建 Swarms 时三种情况都遇到了。导入 LiteLLM 会加载约 2,500 个模块,并且默认会在我们的代码运行之前从 GitHub 下载一份模型价格表。之后的每次调用还要经过日志对象、钩子和响应转换,而这些都是我们的智能体用不到的。RouteHub 就是我们想要的网关:调用方式保持不变,你的代码和提供商官方 SDK 之间的环节尽可能少。
依赖同样重要。网关安装的每一个包,都是带着你的 API key 运行的代码。2026 年 3 月,PyPI 上有两个 LiteLLM 版本被植入了凭证窃取程序,其中一个通过 .pth 文件实现,只要 Python 启动就会执行,即使从未导入 LiteLLM。RouteHub 只有三个直接依赖(openai、pydantic 和 tiktoken),总共安装 21 个包,LiteLLM 则需要 58 个。
RouteHub 遵循一条原则:调用方和官方提供商 SDK 之间做的事越少越好。每次调用只拆分一次,分成请求参数和网关选项,然后在提供商表中查找模型字符串,请求随后走以下两条路径之一:
openai.OpenAI 客户端发送请求,RouteHub 原样返回 SDK 的响应对象。六项技术让开销保持在很低的水平。
1. 懒加载。 import routehub 不会加载任何第三方代码。包把每个公开名称映射到定义它的子模块,在你第一次使用这个名称时才导入对应的子模块。导入 RouteHub 只会在 sys.modules 中增加 18 项:包本身和 17 个标准库模块。OpenAI SDK 在第一次请求需要时才加载,分词器和模型目录只在你统计 token 或查询模型信息时才加载。一个导入了 RouteHub 但从不发送请求的进程,比如打印 --help 的 CLI,或者模拟了模型的测试,永远不需要为 SDK 付出代价。
2. 导入时零网络请求。 在真正发出请求之前,RouteHub 不会访问网络。模型信息(上下文窗口、价格和能力标记)来自 OpenRouter 的实时模型列表,在第一次查询时获取并缓存五分钟。不需要随包附带会过期的数据文件,也不会有下载拖慢启动。
3. 精简的热路径。 RouteHub 在 SDK 之前做的工作只有几次字典操作。当消息列表里没有需要移除的内容时,列表会原样传下去,所以常见情况下不会复制任何东西。响应从不重新校验或重新包装:SDK 已经把它们解析成了类型化对象,你拿到的就是这些对象。
4. 客户端池化。 构建一个 SDK 客户端需要创建 HTTP 客户端、连接池和 SSL 上下文。RouteHub 用缓存保存最多 64 个客户端,缓存键包含所有会改变客户端行为的设置:提供商、API key、基础 URL、重试次数、TLS 设置,异步客户端还包括事件循环。重复调用会复用已经预热的客户端,设置不同的两个调用方各自拿到自己的客户端。
5. 跨智能体步骤复用 HTTP 连接。 httpx 和 OpenAI SDK 默认在连接空闲 5 秒后关闭它。这对浏览器很合适,但如果智能体的工具运行超过五秒,每一步都要重新连接。RouteHub 把连接保持 60 秒,TCP 和 TLS 握手每个连接只发生一次,耗时较长的工具调用也不会触发新的握手。
6. 原生 Anthropic 适配器。 Anthropic 的 OpenAI 兼容端点会丢弃提示缓存、思考输出和缓存 token 用量。RouteHub 直接调用 Messages API,因此 cache_control 标记、扩展思考、带签名的思考块、工具调用、图片、PDF 和缓存 token 统计都能正常工作。流式输出方面,一个增量解析器读取 Anthropic 的事件流,每收到一段文本、思考内容或工具参数增量,就输出一个 OpenAI 分块。
还有一个设计对多智能体系统很重要:RouteHub 没有全局设置。重试、TLS 校验、超时和参数丢弃都是每次调用的参数。一个智能体设置的 ssl_verify=False 或重试策略,永远不会影响同一进程中的另一个智能体。
我们把 RouteHub 与 LiteLLM 1.104.0、any-llm 1.30.0、aisuite 0.2.0 以及裸 OpenAI 和 Anthropic SDK 做了对比。这些库的版本要求互相冲突,所以每个库都运行在各自的虚拟环境中,每次测量都在一个全新的进程里进行,不设置任何 API key 或代理。调用发往同一台机器上一个即时响应的模拟服务器,这样就排除了网络和模型的时间,只剩下每个库在客户端做的工作。为了让 LiteLLM 处于最佳状态,这些测试中我们关闭了它从 GitHub 下载价格表的功能。所有结果都来自一台 Apple M3 Pro 笔记本,运行 Python 3.12。
| 导入 | 导入 + 首个响应 | 峰值内存 | 导入时加载的模块 | |
|---|---|---|---|---|
| RouteHub | 3.2 ms | 267 ms | 54 MiB | 18 |
| OpenAI SDK(裸调用) | 217 ms | 258 ms | 53 MiB | 782 |
| aisuite | 93 ms | 307 ms | 59 MiB | 278 |
| any-llm | 569 ms | 624 ms | 87 MiB | 2,163 |
| LiteLLM | 1,235 ms | 1,464 ms | 211 MiB | 2,502 |
以上为 20 个新进程的中位数。RouteHub 的导入速度比 LiteLLM 快 383 倍。由于 RouteHub 在第一次请求时才加载 OpenAI SDK,最公平的比较是导入加首个响应:RouteHub 为 267 毫秒,与裸 OpenAI SDK 只差 9 毫秒,比 LiteLLM 快 5.5 倍。峰值内存的排序相同,RouteHub 与裸 SDK 相差约 1 MB。如果使用 LiteLLM 的默认设置,下载价格表会让导入再多花 145 毫秒,而且导入还要依赖 GitHub 能否访问。
你可能还在 RouteHub 的 README 中看到过导入快 190 倍的说法。那个数字来自更早、更简单的一次测量,对比的是 LiteLLM 1.76.1(导入 5.5 毫秒对 1,027 毫秒,单次调用开销 0.004 毫秒对 0.74 毫秒)。本文的数据来自我们技术报告中的完整基准测试,它使用了更新版本的 LiteLLM,并把每个库隔离在各自的环境中。两次测量的结论一致。
下表为预热后顺序调用的延迟中位数,单位为毫秒,每项 1,200 次调用。“智能体”请求模拟真实的智能体回合:一个系统提示、20 轮历史对话和一条新消息(共 22 条消息),外加四个工具。
| OpenAI,1 条消息 | OpenAI,智能体 | Anthropic,1 条消息 | Anthropic,智能体 | |
|---|---|---|---|---|
| 提供商 SDK(裸调用) | 0.54 | 2.04 | 0.42 | 0.45 |
| RouteHub | 0.55 | 2.08 | 0.26 | 0.29 |
| aisuite | 0.51 | 2.08 | 0.46 | 1.25 |
| any-llm(AnyLLM 客户端) | 0.75 | 2.40 | 0.69 | 1.48 |
| LiteLLM | 1.19 | 2.78 | 0.98 | 1.12 |
在 OpenAI 路径上,RouteHub 在裸 SDK 调用之上只增加 9 微秒,处于多次运行之间的误差范围内,智能体请求增加 32 微秒。LiteLLM 分别增加 647 微秒和 736 微秒,any-llm 的客户端分别增加 210 微秒和 354 微秒。aisuite 同样把请求直接交给 SDK,在这条路径上和 RouteHub 一样轻量,不过它要求使用较旧的 openai 1.x 版本。统计函数调用次数能更精确地说明问题:每个请求中,RouteHub 在 SDK 自身之外只多执行 70 次 Python 函数调用,LiteLLM 则多执行 4,615 次。
在 Anthropic 路径上,RouteHub 比官方 Anthropic SDK 更快:单条消息 0.26 毫秒对 0.42 毫秒,智能体请求 0.29 毫秒对 0.45 毫秒。而且 RouteHub 还要把 OpenAI 格式的请求转换成 Anthropic 格式,再把响应转换回来。适配器只对请求体编码一次,通过池化的连接发送,然后把回复直接读入 ChatCompletion;SDK 则会构建自己的类型化请求和响应模型。aisuite 和 any-llm 先调用 Anthropic SDK,再转换它的结果,两份开销都要付。
下表为消费一个 200 分块的流所需的时间,单位为毫秒,取 200 个流的中位数:
| OpenAI,首个分块 | OpenAI,完整流 | Anthropic,首个分块 | Anthropic,完整流 | |
|---|---|---|---|---|
| 提供商 SDK(裸调用) | 1.00 | 9.8 | 0.41 | 2.4 |
| RouteHub | 0.82 | 9.1 | 0.29 | 1.2 |
| aisuite | 0.68 | 8.1 | 0.49 | 3.0 |
| any-llm(AnyLLM 客户端) | 7.42 | 11.8 | 7.36 | 9.9 |
| LiteLLM | 16.61 | 61.1 | 14.69 | 66.6 |
在 Anthropic 路径上,RouteHub 自己解析事件流并构建每一个 OpenAI 分块,完成整个流的时间仍然只有 Anthropic SDK 处理其原生事件的一半:每个分块 5 微秒对 10 微秒。LiteLLM 每个分块要花 224 到 261 微秒。同时运行的流越多,每个分块的开销累积得越多。按每秒 100 个分块计算,每个分块 0.2 毫秒意味着每个打开的流要占用 2% 的 CPU 核心,一个同时处理 50 个流的进程光是处理分块就要用掉一整个核心。
同一台机器上的模拟服务器无法体现建立连接的开销,因此在这项测试中,我们用一个故意无效的 key 向 api.openai.com 发送请求。API 会立即返回 401,所以测到的时间就是连接开销加一次往返,不包含模型时间,也不会产生费用。每个客户端先建立连接,等待 10 秒(模拟智能体等待一个较慢的工具),再发送一次计时请求。
连续发送的请求,所有客户端都在 94 到 102 毫秒之间。在 10 秒的停顿之后,RouteHub 复用了仍然打开的连接,116 毫秒就得到响应。裸 OpenAI SDK 和 LiteLLM 已经关闭了连接,需要重新连接,分别耗时 166 毫秒和 185 毫秒。也就是说,只要工具调用超过五秒,每一个智能体步骤都能省下 67 毫秒;在一个 50 步的智能体运行中,相当于省下约 3.3 秒纯粹用于建立连接的时间。这些数据来自同一个地点,离提供商越远,节省得越多。
在低并发下,RouteHub 的异步吞吐量与其单次调用开销一致:Anthropic 路径上每秒 2,435 个请求,Anthropic SDK 为 1,711,LiteLLM 为 907。随着并发升高,所有基于 httpx 的客户端都会变慢,裸 SDK 也不例外。当同时有 128 个请求在途时,LiteLLM 基于 aiohttp 的传输层反超:OpenAI 路径上每秒 876 个请求,RouteHub 为 711;Anthropic 路径上为 942 对 865。在这个并发水平上,瓶颈在于共用的 HTTP 库,而不在 RouteHub 自己的代码。两个提供商 SDK 都自带 aiohttp 后端,RouteHub 可以把它作为一个可选项提供出来。
OpenAI 路径上剩下的最大开销在 OpenAI SDK 内部:它在发送请求之前会遍历并转换每一条消息和每一个工具定义。RouteHub 的 Anthropic 路径已经自己序列化请求体,这就是为什么同样 22 条消息的智能体请求在那里只要 0.29 毫秒,而在 OpenAI 路径上需要 2.08 毫秒。
LiteLLM 的功能也比 RouteHub 多得多:代理服务器、预算、花费记录、缓存、回调,以及覆盖 100 多家提供商的路由。它的单次调用开销有一部分正是为这些功能付出的。我们的看法是,这些功能应该放在每次请求的路径之外,放在你的应用或单独的服务里,让客户端的开销和它所封装的 SDK 相当。

从 PyPI 安装 RouteHub:
pip install routehub

# Or with uv
uv add routehub

# With orjson for faster JSON handling
pip install "routehub[fast]"
设置提供商 key 并发起调用:
export OPENAI_API_KEY="sk-..."import routehub
response = routehub.completion(
model="gpt-5.4-mini",
messages=[{"role": "user", "content": "Summarize our Q3 risks in three bullets."}],
)
print(response.choices[0].message.content)
print(response.usage.total_tokens)改一下模型字符串就能切换提供商,调用方式和响应类型都不变:
messages = [{"role": "user", "content": "Summarize our Q3 risks in three bullets."}]

routehub.completion(model="claude-sonnet-4-6", messages=messages)
routehub.completion(model="gemini/gemini-3-flash-preview", messages=messages)
routehub.completion(model="groq/llama-3.3-70b-versatile", messages=messages)
routehub.completion(model="openrouter/anthropic/claude-sonnet-4.6", messages=messages)
用同一个函数实现流式输出、异步调用和工具调用:
import asyncio

weather = {
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Get the weather for a city.",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    },
}

for chunk in routehub.completion(model="claude-sonnet-4-6", messages=messages, stream=True):
    print(chunk.choices[0].delta.content or "", end="")

response = asyncio.run(
    routehub.acompletion(model="gpt-5.4-mini", messages=messages, tools=[weather])
)
print(response.choices[0].message.tool_calls)
每一种提供商错误都会以类型化异常抛出,例如 RateLimitError、ContextWindowExceededError 或 AuthenticationError,并附带状态码、提供商和模型。每个异常都继承自对应的 OpenAI SDK 异常,所以你现有的错误处理代码可以继续使用。写测试时,传入 mock_response="..." 就能拿到一个逼真的响应(或流),不需要网络请求,也不需要 API key。
RouteHub 使用与 LiteLLM 相同的函数名和模块路径,所以大多数代码只需要换一行导入:
| LiteLLM | RouteHub |
|---|---|
from litellm import completion, acompletion, embedding | from routehub import completion, acompletion, embedding |
from litellm.utils import get_model_info | from routehub.utils import get_model_info |
from litellm.exceptions import AuthenticationError | from routehub.exceptions import AuthenticationError |
litellm.drop_params = True | completion(..., drop_params=True) |
litellm.num_retries = 3 | completion(..., num_retries=3) |
有两点不同需要注意:设置是每次调用的参数,而不是模块级全局变量;响应是 OpenAI SDK 对象,要用属性(response.choices)或 .model_dump() 读取,不能用字典键。其余内容请参阅 README,包括 Claude 的提示缓存、推理、结构化输出、嵌入、实时模型目录,以及所有支持的提供商。
RouteHub 也将成为 Swarms 框架中模型调用的快速路径。安装 swarms[fast] 会同时安装 RouteHub,之后 Swarms 的每一次模型调用都会经过 RouteHub,而不是 LiteLLM。你的智能体代码不需要任何改动。在我们的测试中,一个新进程拿到智能体首个回答的时间从 1.2 秒缩短到约 0.6 秒,每次模型调用在客户端库中花费的时间也减少了约一半。
fast 扩展已经合入 Swarms 的主分支,会包含在 PyPI 的下一个版本中。在此之前,你可以从 GitHub 安装:
pip install "swarms[fast] @ git+https://github.com/kyegomez/swarms.git"本文中的设计和每一项基准测试,都在我们的技术报告 RouteHub: A Low-Overhead, SDK-Native LLM Gateway for Agentic Workloads 中有详细介绍,作者为 Kye Gomez、Shryuk Grandhi 和 Ayaan Gazali。报告涵盖架构、六项技术背后的代码、完整的测试方法、每项结果的图表、各个库把时间花在哪里的性能剖析,以及这项研究的局限,包括所有结果都来自一台机器,以及基准测试由 RouteHub 自己的开发者编写。
RouteHub 还很年轻。0.2.0 版本已在 PyPI 上发布,还有很多工作要做。即便在这个阶段,它在对智能体最重要的指标上已经领先于最流行的 LLM 网关:导入速度比 LiteLLM 快 383 倍,拿到首个响应快 5.5 倍,内存少 3.9 倍,在 OpenAI SDK 之上几乎没有额外开销,Claude 调用和流式输出比官方 Anthropic SDK 还快。
接下来的路线图包括:面向高并发负载的 aiohttp 传输选项、在 OpenAI 路径上跳过 OpenAI SDK 的请求转换、可选的 HTTP/2 传输、OpenAI Responses API、提供商批处理 API,以及 Amazon Bedrock 和 Google Vertex AI 的原生适配器。每一项都会在每次请求的路径之外实现,让 RouteHub 在功能增长的同时,开销依然和它底层的 SDK 相当。
RouteHub 是开源项目,欢迎你一起帮它变得更快。
pip install routehub 或 uv add routehub 安装。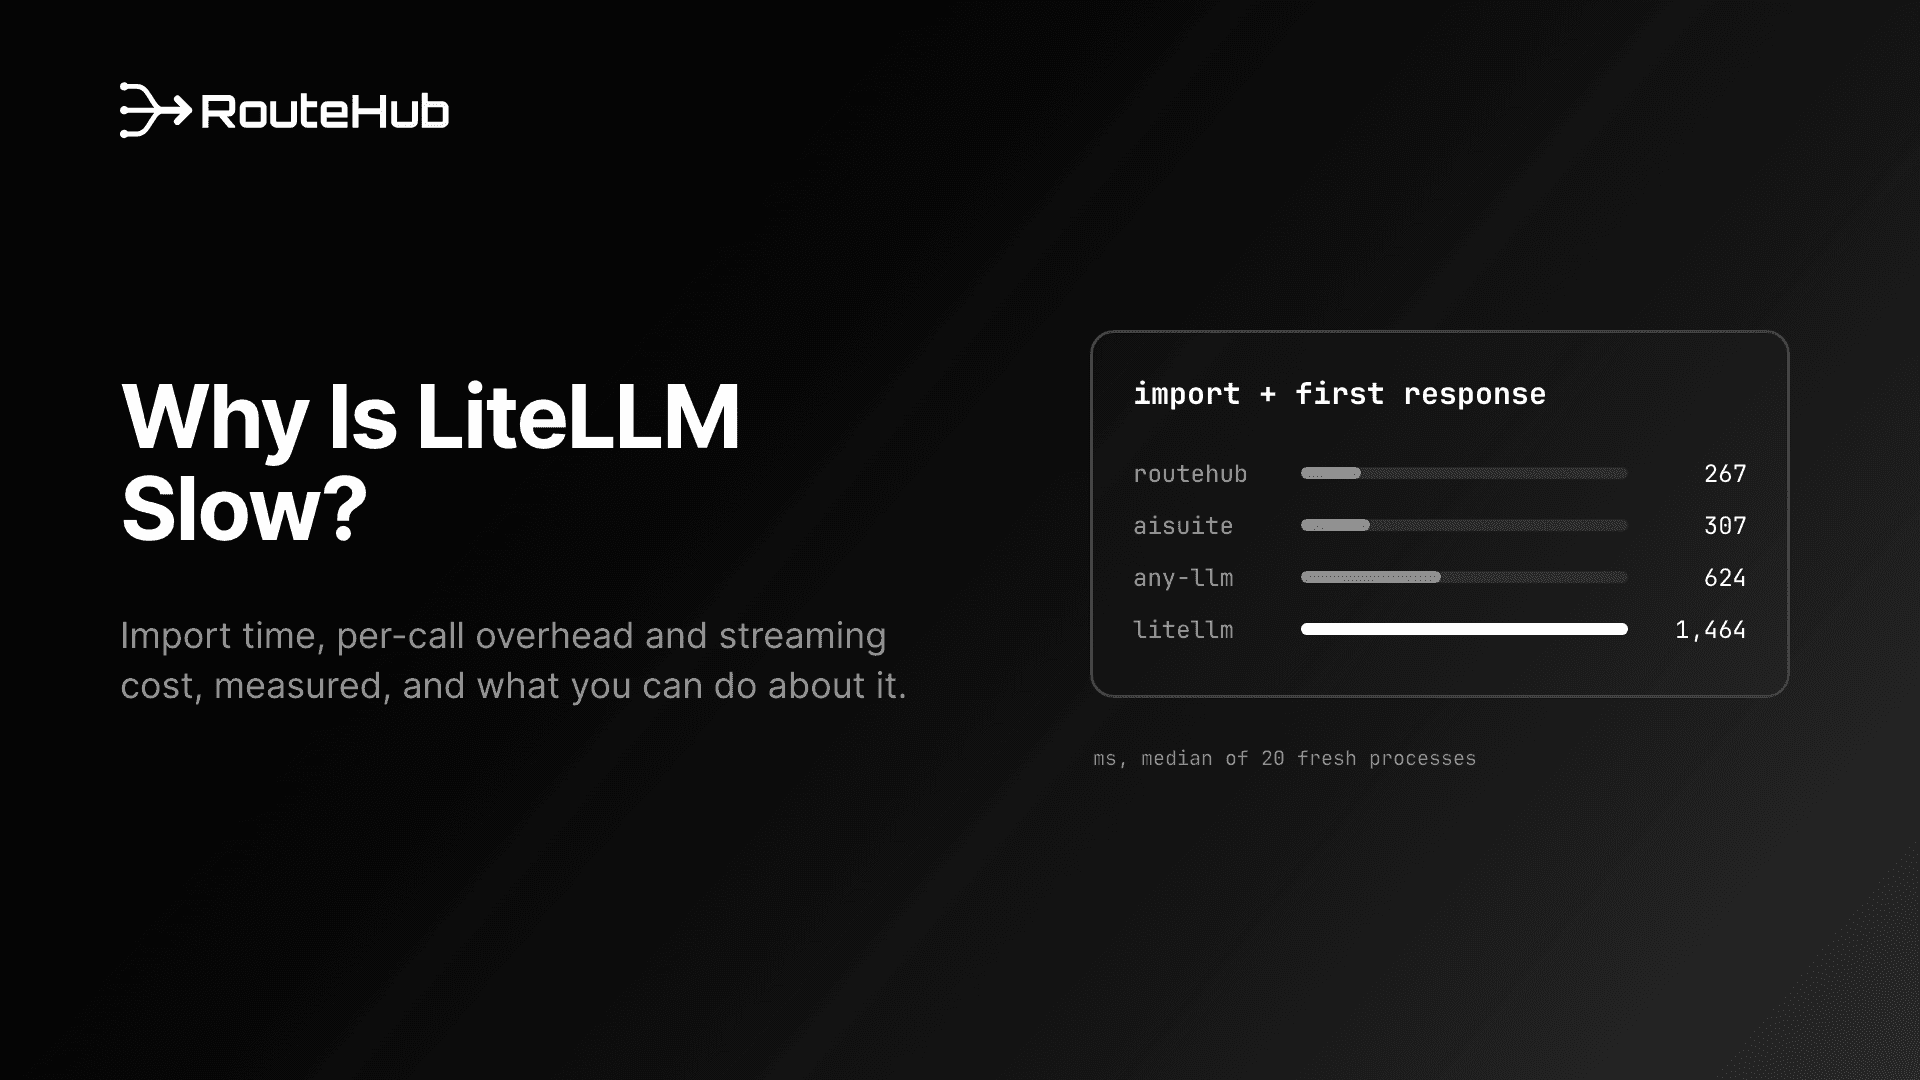
LiteLLM 为什么慢?我们实测了它约 1.2 秒的导入时间、单次调用开销、流式输出成本和内存占用,并介绍官方文档中的优化方法,以及什么时候应该换用其他网关。
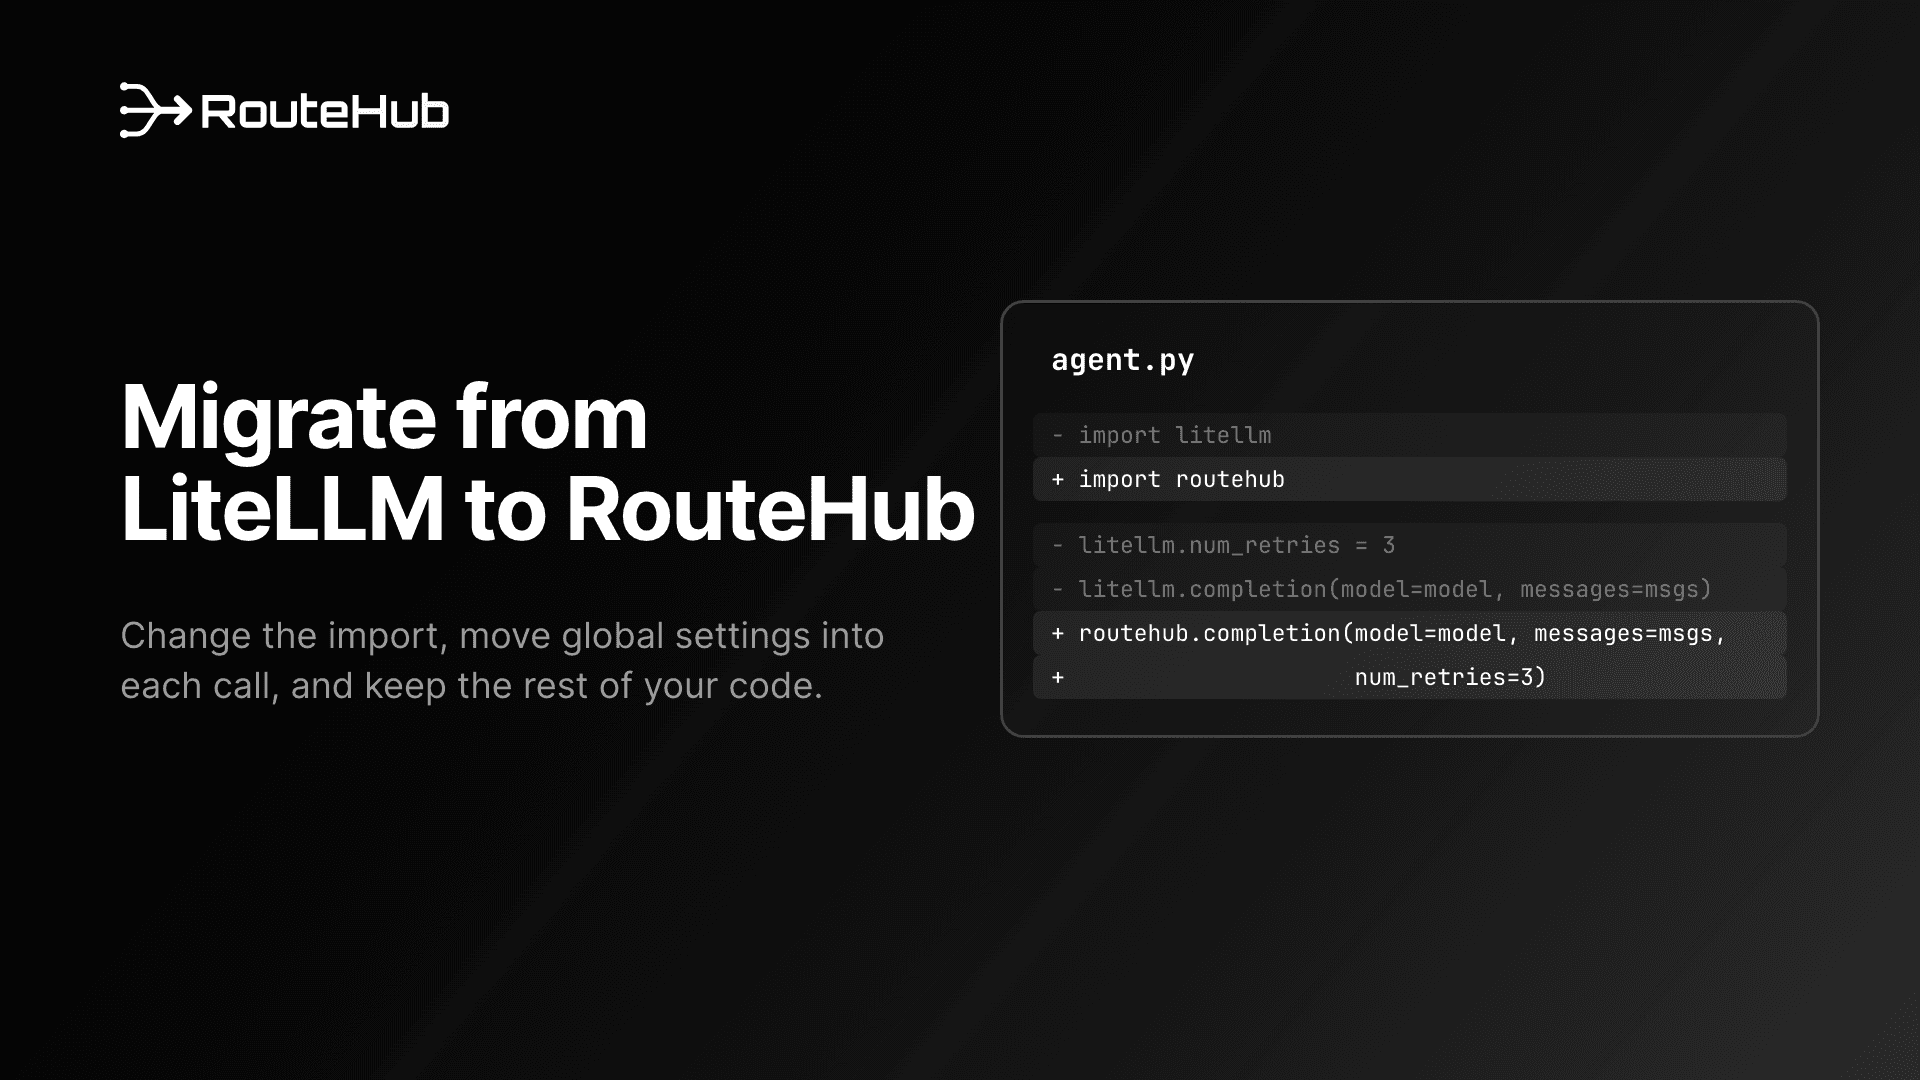
从 LiteLLM 迁移到 RouteHub 的分步指南:替换导入,把 litellm 全局设置改为每次调用的参数,并更新响应读取、工具调用、异常处理和测试。
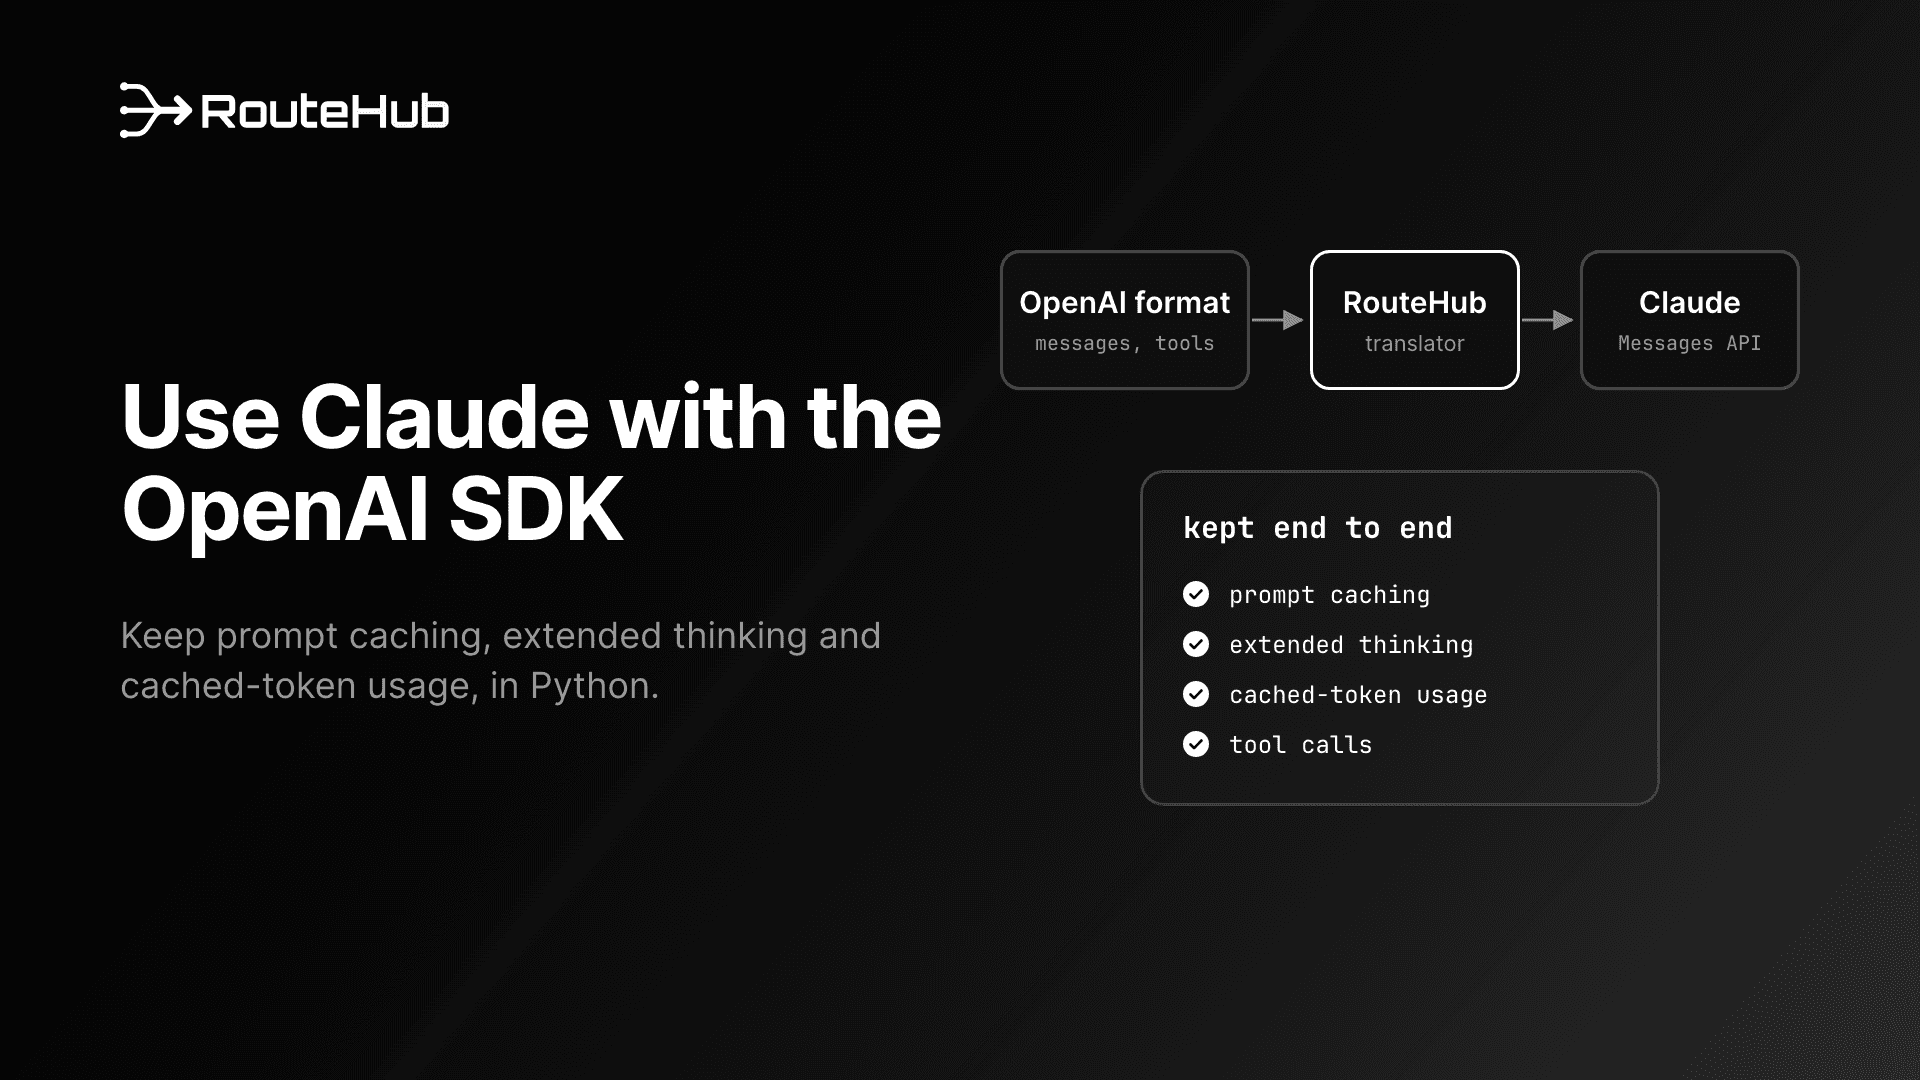
了解如何在 Python 中通过 OpenAI SDK 格式使用 Claude、Anthropic 兼容端点会丢掉哪些功能,以及如何保留提示缓存、思考输出和 PDF 支持。