指南工程
如何从 LiteLLM 迁移到 RouteHub:分步指南
从 LiteLLM 迁移到 RouteHub 的分步指南:替换导入,把 litellm 全局设置改为每次调用的参数,并更新响应读取、工具调用、异常处理和测试。
Swarms 团队13 分钟阅读

从 LiteLLM 迁移到 RouteHub 的分步指南:替换导入,把 litellm 全局设置改为每次调用的参数,并更新响应读取、工具调用、异常处理和测试。
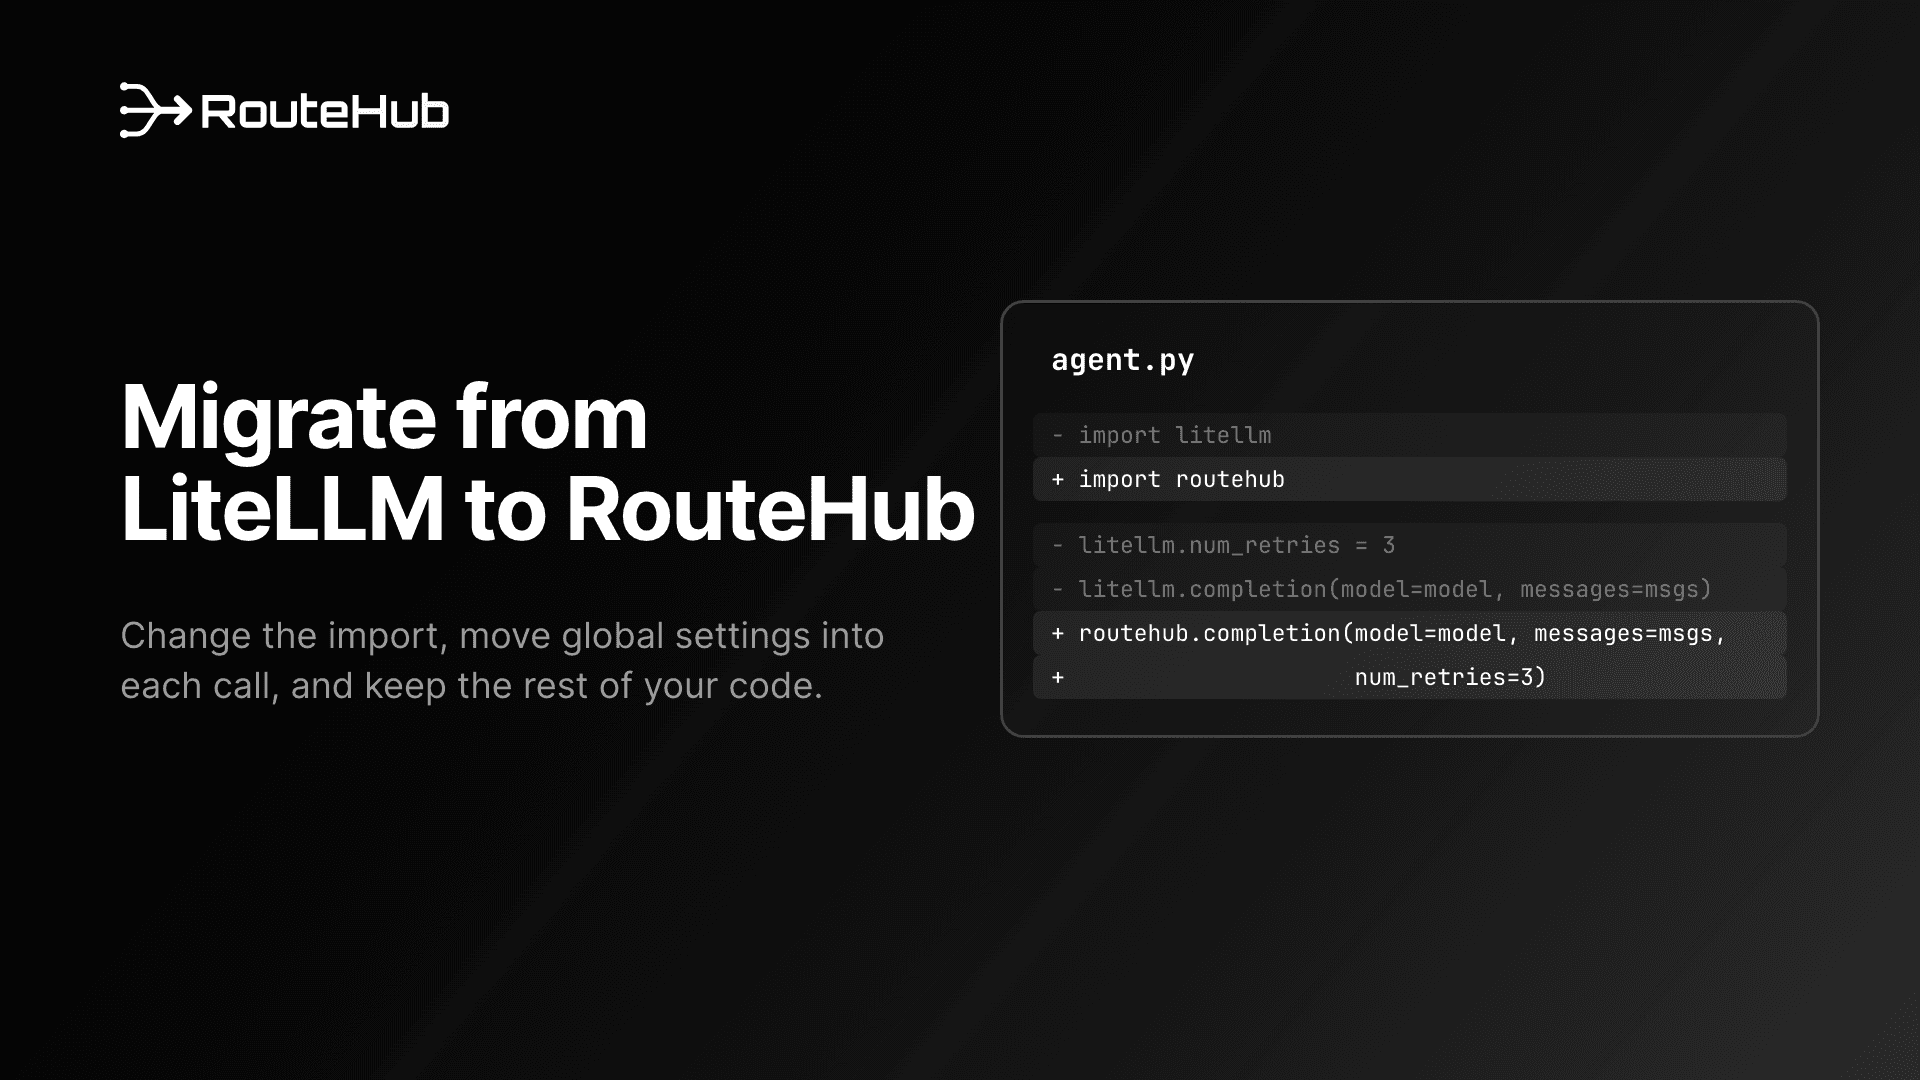
如果你想从 LiteLLM 迁移到一个更轻量的网关,RouteHub 正是为这种迁移而设计的。它沿用了 LiteLLM 的函数名和模块路径(completion、acompletion、embedding、routehub.utils、routehub.exceptions),所以大部分工作只是修改导入。不过有几处行为确实不同,本指南会逐一说明,并附上可以直接复制的代码:设置、响应对象、流式输出、工具调用、结构化输出、Claude 功能、嵌入、模型信息、异常、测试,以及 RouteHub 有意不提供的 LiteLLM 功能。
下面每一段 RouteHub 代码在发布前都已在 RouteHub 0.2.0 上运行过,使用的是 mock_response 或本地模拟服务器,因此不需要任何 API key。
主要原因是每个进程和每次调用的开销。下表来自我们技术报告中的基准测试,在同一台机器上与 LiteLLM 1.104.0 对比:
| LiteLLM 1.104.0 | RouteHub | |
|---|---|---|
import 耗时 | 1,235 ms | 3.2 ms |
| 新进程中导入加首个响应 | 1,464 ms | 267 ms |
| 首次请求后的峰值内存 | 211 MiB | 54 MiB |
| 在裸 OpenAI SDK 调用之上增加的时间 | 647 µs | 9 µs |
| 安装的包数量 | 58 | 21 |
也就是说,导入快 383 倍,拿到首个响应快 5.5 倍,内存少 3.9 倍。RouteHub 还会直接调用 Claude 的原生 Messages API,并返回官方 OpenAI SDK 自己的 ChatCompletion 对象。发布文章介绍了它是怎么做到的,LiteLLM 为什么慢?则分析了 LiteLLM 的导入时间和单次调用时间花在了哪里。
留在 LiteLLM 的理由是功能。LiteLLM 是一个大得多的项目:代理服务器、带负载均衡的 Router、对接日志和可观测性工具的回调、预算、缓存层,以及 100 多家提供商。如果你的应用依赖这些功能,请在开始之前先阅读下面关于 LiteLLM 独有功能的第 10 步。想更全面地比较各种选择,请看最佳 LiteLLM 替代方案。
对核心调用来说,基本可以。函数名相同,接受同样的 OpenAI 格式参数,提供商前缀也一样(anthropic/、gemini/、groq/、openrouter/、azure/、ollama/、hosted_vllm/ 等),常见的提供商环境变量,比如 OPENAI_API_KEY、ANTHROPIC_API_KEY、GEMINI_API_KEY、GROQ_API_KEY 和 AZURE_API_KEY,读取的名称也相同。
在四个方面它不能直接替换,下面的步骤会逐一处理:
litellm.drop_params 这类模块级设置。routehub。 大多数 LiteLLM 异常名称都存在,但有几个 LiteLLM 特有的异常没有。Router、fallbacks、回调、预算、缓存、completion_cost 和 stream_chunk_builder。| LiteLLM | RouteHub |
|---|---|
pip install litellm | pip install routehub |
from litellm import completion, acompletion, embedding | from routehub import completion, acompletion, embedding |
from litellm.utils import get_model_info, supports_vision | from routehub.utils import get_model_info, supports_vision |
from litellm.exceptions import AuthenticationError | from routehub.exceptions import AuthenticationError |
from litellm import model_list, encode, token_counter | from routehub import model_list, encode, token_counter |
litellm.drop_params = True | completion(..., drop_params=True) |
litellm.num_retries = 3 | completion(..., num_retries=3) |
litellm.ssl_verify = False | completion(..., ssl_verify=False) |
litellm.set_verbose = True | completion(..., set_verbose=True) |
litellm.api_key = "..." | completion(..., api_key="...") 或提供商的环境变量 |
response["choices"][0]["message"]["content"] | response.choices[0].message.content |
ModelResponse | openai.types.chat.ChatCompletion |
pip install routehub

# Or with uv
uv add routehub

# Optional: orjson for faster JSON handling
pip install "routehub[fast]"
RouteHub 需要 Python 3.10 或更高版本,直接依赖只有 openai、pydantic 和 tiktoken。迁移期间可以保留 LiteLLM,等代码里不再导入它之后再移除。
把所有从 litellm 导入的地方改成 routehub,模块结构是一样的:
from routehub import completion, acompletion, embedding, aembedding
from routehub import model_list, encode, token_counter
from routehub.utils import get_model_info, get_max_tokens, supports_vision
from routehub.exceptions import (
    AuthenticationError,
    ContextWindowExceededError,
    RateLimitError,
)
在代码库中同时搜索 import litellm 和 from litellm 两种写法,这样 litellm.completion(...) 这种模块式调用也不会漏掉。
有一个捷径要避免:import routehub as litellm。调用本身能工作,但像 litellm.drop_params = True 这样的语句只会设置一个 RouteHub 永远不会读取的属性,而且不会有任何报错提醒你这个设置丢了。请显式改名,让每一个全局设置都在第 3 步中暴露出来。
LiteLLM 从模块全局变量中读取很多设置,其中包括 litellm.drop_params、litellm.num_retries、litellm.ssl_verify、litellm.set_verbose、litellm.api_key 和 litellm.api_base。RouteHub 把每个设置都作为调用参数传入。这样在多个智能体或租户共享的进程里,一个组件的 TLS 或重试设置不会改变另一个组件的行为。
| 参数 | 默认值 | 在 RouteHub 中的作用 |
|---|---|---|
drop_params | False | 丢弃模型不接受的参数:OpenAI 推理模型上的采样参数、不支持推理的模型上的 reasoning_effort、较旧 Claude 模型上的 thinking,以及未知的关键字参数。 |
num_retries | None(重试 2 次) | 对限流、5xx 错误和连接失败进行重试,使用指数退避并遵循 retry-after。 |
ssl_verify | True | TLS 校验,或 CA 证书包的路径。 |
set_verbose | False | 向 stderr 打印提供商、模型、参数名和耗时。API key 和消息内容永远不会被打印。 |
request_timeout / timeout | 600.0 | 请求超时时间,单位为秒。两者都设置时以 timeout 为准。 |
api_key、api_base(或 base_url) | 从环境变量读取 | 本次调用使用的凭证和端点。 |
如果你原来在启动时统一设置全局变量,可以用 functools.partial 绑定默认值,继续只在一个地方管理:
from functools import partial

import routehub

complete = partial(
    routehub.completion,
    drop_params=True,
    num_retries=3,
    ssl_verify="/etc/ssl/corp-ca.pem",
)
acomplete = partial(routehub.acompletion, drop_params=True, num_retries=3)

response = complete(model="gpt-5.4-mini", messages=messages)
然后把 litellm.completion 调用替换成 complete。在调用处传入的参数仍然会覆盖绑定的默认值。
关于 drop_params 还有两点。LiteLLM 的 additional_drop_params 会被接受但忽略,如果你用它来去掉某个特定字段,请自己从请求中删除那个字段。另外,RouteHub 不读取 LiteLLM 的 SSL_VERIFY 环境变量,所以请显式传入 ssl_verify。
LiteLLM 返回自己的 ModelResponse,同时支持属性访问和字典访问。RouteHub 返回 OpenAI SDK 的 ChatCompletion,这是一个 pydantic 模型,所以字典访问会抛出 TypeError: 'ChatCompletion' object is not subscriptable。
# Attribute access works in both libraries
text = response.choices[0].message.content
tokens = response.usage.total_tokens

# Where you need a dict, convert once
data = response.model_dump()
text = data["choices"][0]["message"]["content"]
payload = response.model_dump_json()
搜索 ["choices"]、["usage"] 和 .get("choices",就能找到需要修改的地方。原来标注为 ModelResponse 的类型提示改成 openai.types.chat.ChatCompletion,类型检查器看到的就是真实的 OpenAI 结构。
所有提供商的用量都以同一种结构返回:prompt_tokens、completion_tokens、total_tokens、prompt_tokens_details.cached_tokens,以及提供商有报告时的推理 token。
流式输出的代码通常不需要修改。RouteHub 产出 OpenAI 的 ChatCompletionChunk 对象,开启 include_usage 后,最后一个分块携带用量且不含 choices,和 OpenAI 的行为一致:
stream = routehub.completion(
    model="claude-sonnet-4-6",
    messages=messages,
    stream=True,
    stream_options={"include_usage": True},
)
for chunk in stream:
    if chunk.usage:
        print("\nusage:", chunk.usage)
    elif chunk.choices and chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="", flush=True)
流也可以放在 with 块中使用,这样提前停止读取时连接会被关闭。异步代码的写法也保持不变:
import asyncio

async def main():
    response = await routehub.acompletion(model="gpt-5.4-mini", messages=messages)
    stream = await routehub.acompletion(model="gpt-5.4-mini", messages=messages, stream=True)
    async for chunk in stream:
        if chunk.choices and chunk.choices[0].delta.content:
            print(chunk.choices[0].delta.content, end="")

asyncio.run(main())
如果你用过 LiteLLM 的 stream_chunk_builder 从分块重建完整响应,RouteHub 没有这个函数。请在读取过程中收集 delta.content 字符串(如果流式调用工具,还要收集 delta.tool_calls),或者在需要完整对象时使用非流式调用。
工具定义和工具结果消息使用 OpenAI 格式,和在 LiteLLM 中一样。唯一的变化是把助手消息追加到历史记录的方式。在 LiteLLM 中,直接追加 response.choices[0].message 很常见,因为 LiteLLM 的消息对象可以像字典一样使用。在 RouteHub 中,请用 model_dump(exclude_none=True) 转换。在我们的测试中,直接追加原始对象在 OpenAI 路径上可以工作,但在 Anthropic 路径上会抛出 AttributeError,所以请在所有地方都做这个转换:
import json

weather = {
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Get the weather for a city.",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    },
}

messages = [{"role": "user", "content": "What's the weather in Paris?"}]
response = routehub.completion(model="claude-sonnet-4-6", messages=messages, tools=[weather])
message = response.choices[0].message

messages.append(message.model_dump(exclude_none=True))
for call in message.tool_calls or []:
    args = json.loads(call.function.arguments)
    messages.append({"role": "tool", "tool_call_id": call.id, "content": get_weather(**args)})

final = routehub.completion(model="claude-sonnet-4-6", messages=messages, tools=[weather])
print(final.choices[0].message.content)
对于 Claude,RouteHub 会把工具定义、工具调用和工具结果转换成 Anthropic 的格式再转换回来,并行工具调用也包括在内。
把 pydantic 模型作为 response_format 传入,RouteHub 会把它转换成严格的 json_schema 格式。对于 Claude,结构通过一次强制的工具调用来保证,JSON 会作为消息内容返回:
from pydantic import BaseModel

class RiskReport(BaseModel):
    title: str
    severity: int

response = routehub.completion(
    model="gpt-5.4-mini",
    messages=[{"role": "user", "content": "Assess the main risk of a single-region deployment."}],
    response_format=RiskReport,
)
report = RiskReport.model_validate_json(response.choices[0].message.content)RouteHub 调用 Anthropic 的原生 Messages API,所以 OpenAI 兼容端点会丢弃的 Claude 功能都能继续使用。cache_control 标记会原样发给 Anthropic,缓存用量会随响应返回:
messages = [
    {
        "role": "system",
        "content": [
            {"type": "text", "text": policy_handbook, "cache_control": {"type": "ephemeral"}}
        ],
    },
    {"role": "user", "content": "Which policies cover vendor onboarding?"},
]
response = routehub.completion(model="claude-sonnet-4-6", messages=messages)
print(response.usage.prompt_tokens_details.cached_tokens)  # tokens read from cache
print(response.usage.cache_creation_input_tokens)          # tokens written to cache
prompt_tokens 包含缓存读取和写入的 token。Claude 的思考内容出现在消息的 reasoning_content(文本)和 thinking_blocks(带签名的块)上。在多轮工具调用中,Anthropic 要求把思考块随助手消息一起发回,第 6 步中的 model_dump(exclude_none=True) 会保留它们,所以上面的工具循环已经处理好了。如果同一段历史之后发给非 Claude 模型,RouteHub 会在发送前删除这些只属于响应的字段。关于通过 OpenAI 风格 API 调用 Claude 的更多内容,请看如何在 Python 中用 OpenAI 格式调用 Claude。
嵌入的用法相同,返回 SDK 的 CreateEmbeddingResponse:
response = routehub.embedding(model="text-embedding-3-small", input=["first text", "second text"])
vectors = [item.embedding for item in response.data]
token 计数使用 tiktoken 和模型对应的编码;对于 tiktoken 不认识的模型使用 o200k_base,所以非 OpenAI 模型的计数是估算值:
routehub.encode(model="gpt-5.4-mini", text="hello world")
routehub.token_counter(model="gpt-5.4-mini", messages=messages)
模型信息是 RouteHub 与 LiteLLM 差别最大的地方。LiteLLM 随包附带一份价格表,并默认在导入时从 GitHub 下载更新的版本。RouteHub 在第一次查询时读取 OpenRouter 的实时模型列表,并缓存五分钟:
info = routehub.get_model_info("claude-sonnet-4-6")
info["max_input_tokens"]
info["input_cost_per_token"]

routehub.get_max_tokens("gpt-5.4-mini")
routehub.supports_vision("gpt-5.4-mini")
"claude-sonnet-4-6" in routehub.model_list对于未知模型,get_model_info 会抛出 ModelNotMappedError,supports_* 函数返回 False。私有模型、微调模型或自托管模型可以用 register_model 注册,格式与 LiteLLM 的模型信息相同。注册的条目优先级最高,而且永不过期:
routehub.register_model({
    "acme-support-ft": {
        "max_input_tokens": 32768,
        "max_output_tokens": 4096,
        "supports_function_calling": True,
        "input_cost_per_token": 0.000002,
        "output_cost_per_token": 0.000008,
    }
})下面这些 LiteLLM 功能在 RouteHub 中没有对应实现。其中一些 LiteLLM 参数会被接受但忽略,所以请主动搜索它们,不要等着报错。
异常。 RouteHub 提供 BadRequestError、ContextWindowExceededError、ContentPolicyViolationError、UnsupportedParamsError、AuthenticationError、PermissionDeniedError、NotFoundError、UnprocessableEntityError、RateLimitError、InternalServerError、ServiceUnavailableError、Timeout、APIConnectionError、APIError 和 ModelNotMappedError。每个异常都继承自对应的 OpenAI SDK 异常,携带 status_code、llm_provider 和 model,原始错误通过 __cause__ 链接。LiteLLM 1.104.0 还有其他异常,比如 BudgetExceededError、BadGatewayError 和 APIResponseValidationError。提供商返回的 502 在 RouteHub 中会变成 InternalServerError。
try:
    routehub.completion(model="gpt-5.4-mini", messages=messages, num_retries=3)
except routehub.ContextWindowExceededError:
    ...  # trim the conversation and retry
except routehub.RateLimitError as error:
    print(error.status_code, error.llm_provider, error.model)
故障转移。 LiteLLM 的 completion(..., fallbacks=[...]) 和 context_window_fallback_dict 在 RouteHub 中会被接受但忽略,retry_policy 和 num_retries_per_request 也是如此。一个简短的循环就能完成同样的工作,而且规则一目了然:
def complete_with_fallbacks(models, **kwargs):
    last_error = None
    for model in models:
        try:
            return routehub.completion(model=model, **kwargs)
        except (
            routehub.RateLimitError,
            routehub.ServiceUnavailableError,
            routehub.InternalServerError,
            routehub.Timeout,
            routehub.APIConnectionError,
        ) as error:
            last_error = error
    raise last_error

response = complete_with_fallbacks(["gpt-5.4-mini", "claude-sonnet-4-6"], messages=messages)
费用统计。 RouteHub 没有 completion_cost。价格来自 get_model_info,所以一个基础版本只需要几行代码。这个版本按完整的输入单价计算缓存输入,因此会高估使用缓存的提示的费用:
def call_cost(model, response):
    info = routehub.get_model_info(model)
    usage = response.usage
    return (
        usage.prompt_tokens * (info["input_cost_per_token"] or 0)
        + usage.completion_tokens * (info["output_cost_per_token"] or 0)
    )
回调、预算和缓存。 litellm.success_callback、litellm.failure_callback、litellm.max_budget 和 litellm.cache 在 RouteHub 中没有对应功能,metadata 和 caching 参数会被接受但忽略。请把日志和花费统计放进第 3 步中 complete 这样的封装里,在那里读取 response.usage 并为每次调用计时。如果你之前把 metadata 传给 OpenAI 用于存储的补全,请通过 extra_body={"metadata": {...}, "store": True} 发送,RouteHub 总是会转发 extra_body。
Router 和代理。 RouteHub 没有 Router,也没有代理服务器。如果你在多个团队之间用 LiteLLM 代理来管理 key、预算和日志,可以保留它,把 RouteHub 当作调用任何 OpenAI 兼容服务那样指向它:
routehub.completion(
    model="openai/my-model-alias",
    messages=messages,
    api_base="http://0.0.0.0:4000",
    api_key="sk-your-proxy-key",
)
这就是实实在在的取舍:LiteLLM 做的事情更多,它的单次调用开销有一部分正是为这些功能付出的。RouteHub 的立场是,这些功能应该放在每次请求的路径之外,放在你的应用或单独的服务里。
先从你已有的测试开始。mock_response 的用法和 LiteLLM 中一样:它返回一个真实的 ChatCompletion,在 stream=True 时返回一个流,不需要网络请求,也不需要 API key。传入一个异常则可以演练失败处理:
response = routehub.completion(model="gpt-5.4-mini", messages=messages, mock_response="Approved.")

routehub.completion(model="gpt-5.4-mini", messages=messages, mock_response=TimeoutError("simulated outage"))

routehub.completion(
    model="gpt-5.4-mini",
    messages=messages,
    mock_response=routehub.RateLimitError("slow down", llm_provider="openai", model="gpt-5.4-mini"),
)
然后针对真实的提供商检查四件事,你用到的每个提供商各选一个模型:
AuthenticationError,没有 key 时则会在发送任何请求之前就抛出它。第一遍检查时可以开启 set_verbose=True。它会打印每个请求的提供商、基础 URL 和参数名,很快就能发现某个参数被发到了意料之外的地方。
如果你是通过 Swarms 智能体框架使用 RouteHub,上面这些步骤都不需要。swarms[fast] 会安装 RouteHub,之后 Swarms 的每一次模型调用都会经过 RouteHub 而不是 LiteLLM,你的智能体代码不需要任何改动。Swarms 的 README 报告,一个新进程拿到智能体首个回答的时间从 1.2 秒缩短到约 0.6 秒。fast 扩展已经合入 Swarms 的主分支,会包含在 PyPI 的下一个版本中。在此之前可以这样安装:
pip install "swarms[fast] @ git+https://github.com/kyegomez/swarms.git"pip install routehub,所有 litellm 导入都改成了 routehubimport routehub as litellm 这样的别名litellm.<setting> = ... 都改成了调用参数或 functools.partial 封装model_dump()model_dump(exclude_none=True) 追加助手消息except 子句fallbacks、context_window_fallback_dict、metadata 和 caching 参数completion_cost、stream_chunk_builder、回调、预算和 Router 的用法register_model 注册mock_response 下通过,每个提供商都检查过一次真实调用如果你还在挑选网关,Python 中最好的 LLM 网关比较了 RouteHub、LiteLLM、any-llm、aisuite 和裸 SDK。
对于只用 completion、acompletion 和 embedding 并通过属性读取响应的代码,改动主要是导入,一遍就能完成。时间主要花在本指南提到的四个方面:全局设置、响应上的字典访问、异常名称和 LiteLLM 独有功能。搜索 litellm.、["choices"]、fallbacks= 和 metadata=,就能知道每一类有多少要改。
RouteHub 覆盖 20 多家提供商,包括 OpenAI、Anthropic、Gemini、Azure OpenAI、Groq、xAI、DeepSeek、OpenRouter、Together、Mistral、Fireworks、Ollama、vLLM 以及任何兼容 OpenAI 的服务。LiteLLM 覆盖 100 多家。请在 README 的提供商表格中确认你用到的那些。任何提供 OpenAI 兼容端点的提供商都可以通过 api_base 使用。
可以。LiteLLM 代理使用 OpenAI API,所以调用时用 openai/ 模型前缀,把 api_base 设为代理的地址,把代理 key 作为 api_key。这样你保留了代理的预算和日志功能,同时让应用进程不再导入 LiteLLM。
RouteHub 返回 OpenAI SDK 对象,不支持字典访问。把 response["choices"][0]["message"]["content"] 改成 response.choices[0].message.content,或者调用一次 response.model_dump(),继续使用原来的字典代码。
在每次调用时传入 drop_params=True,或者用 functools.partial 统一绑定一次。设置 routehub.drop_params = True 没有任何作用,因为 RouteHub 不读取任何模块级设置。
RouteHub 目前是 0.2.0 版本,Swarms 框架新的 fast 扩展就是基于它构建的。它附带一套离线测试、类型化异常,以及带退避的重试。它比 LiteLLM 更年轻、更小,所以请确认你需要的提供商和功能都已覆盖,缺少的部分欢迎提交 issue。
RouteHub 基于 Apache 2.0 许可证开源。可以从 PyPI 安装,也欢迎在 GitHub 上 Star 和参与贡献。
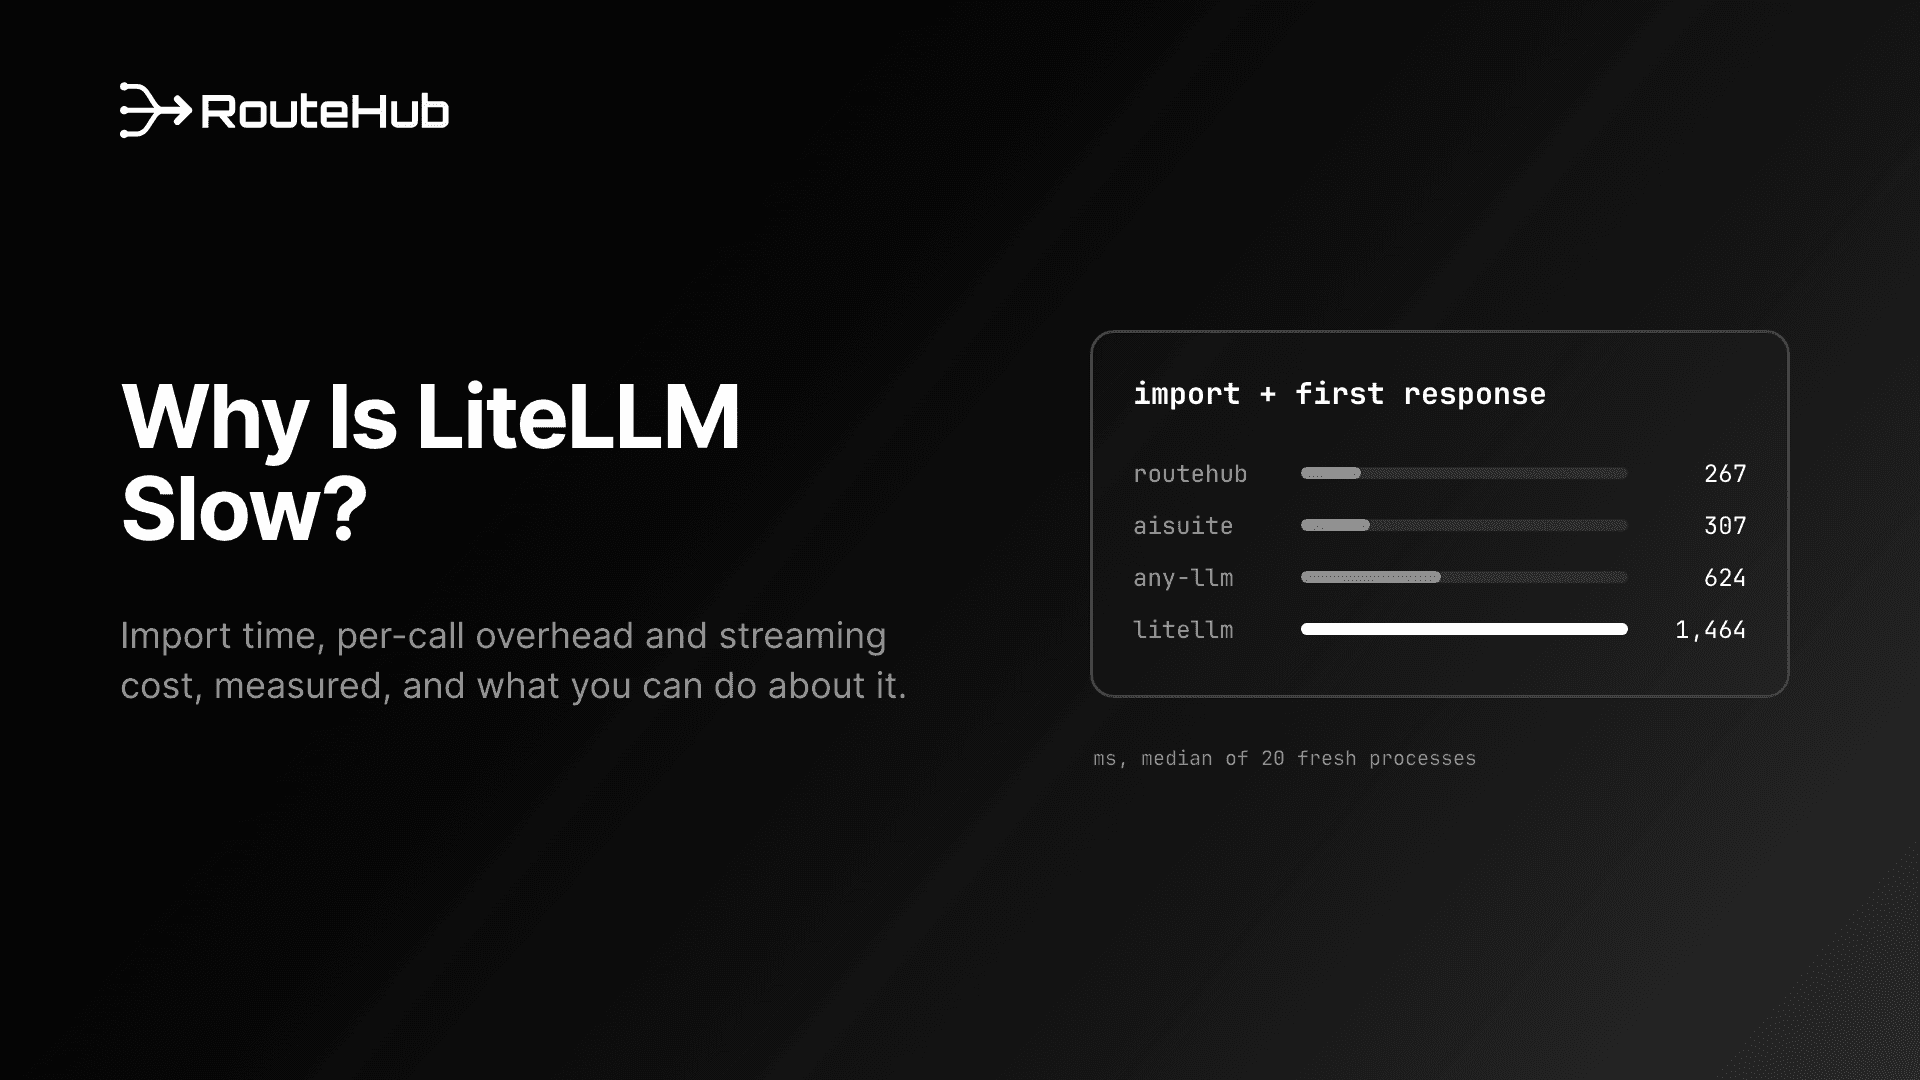
LiteLLM 为什么慢?我们实测了它约 1.2 秒的导入时间、单次调用开销、流式输出成本和内存占用,并介绍官方文档中的优化方法,以及什么时候应该换用其他网关。
RouteHub 是一个开源 LLM 网关,通过一个 API 连接 20 多家模型提供商,支持流式输出、异步调用和工具调用。它的导入速度比 LiteLLM 快 383 倍,拿到首个响应快 5.5 倍,内存占用少 3.9 倍,每次调用只增加 9 微秒开销,在 Claude 调用和流式输出上比官方 Anthropic SDK 还快。本文介绍它的工作原理、完整的基准测试结果,以及如何上手。
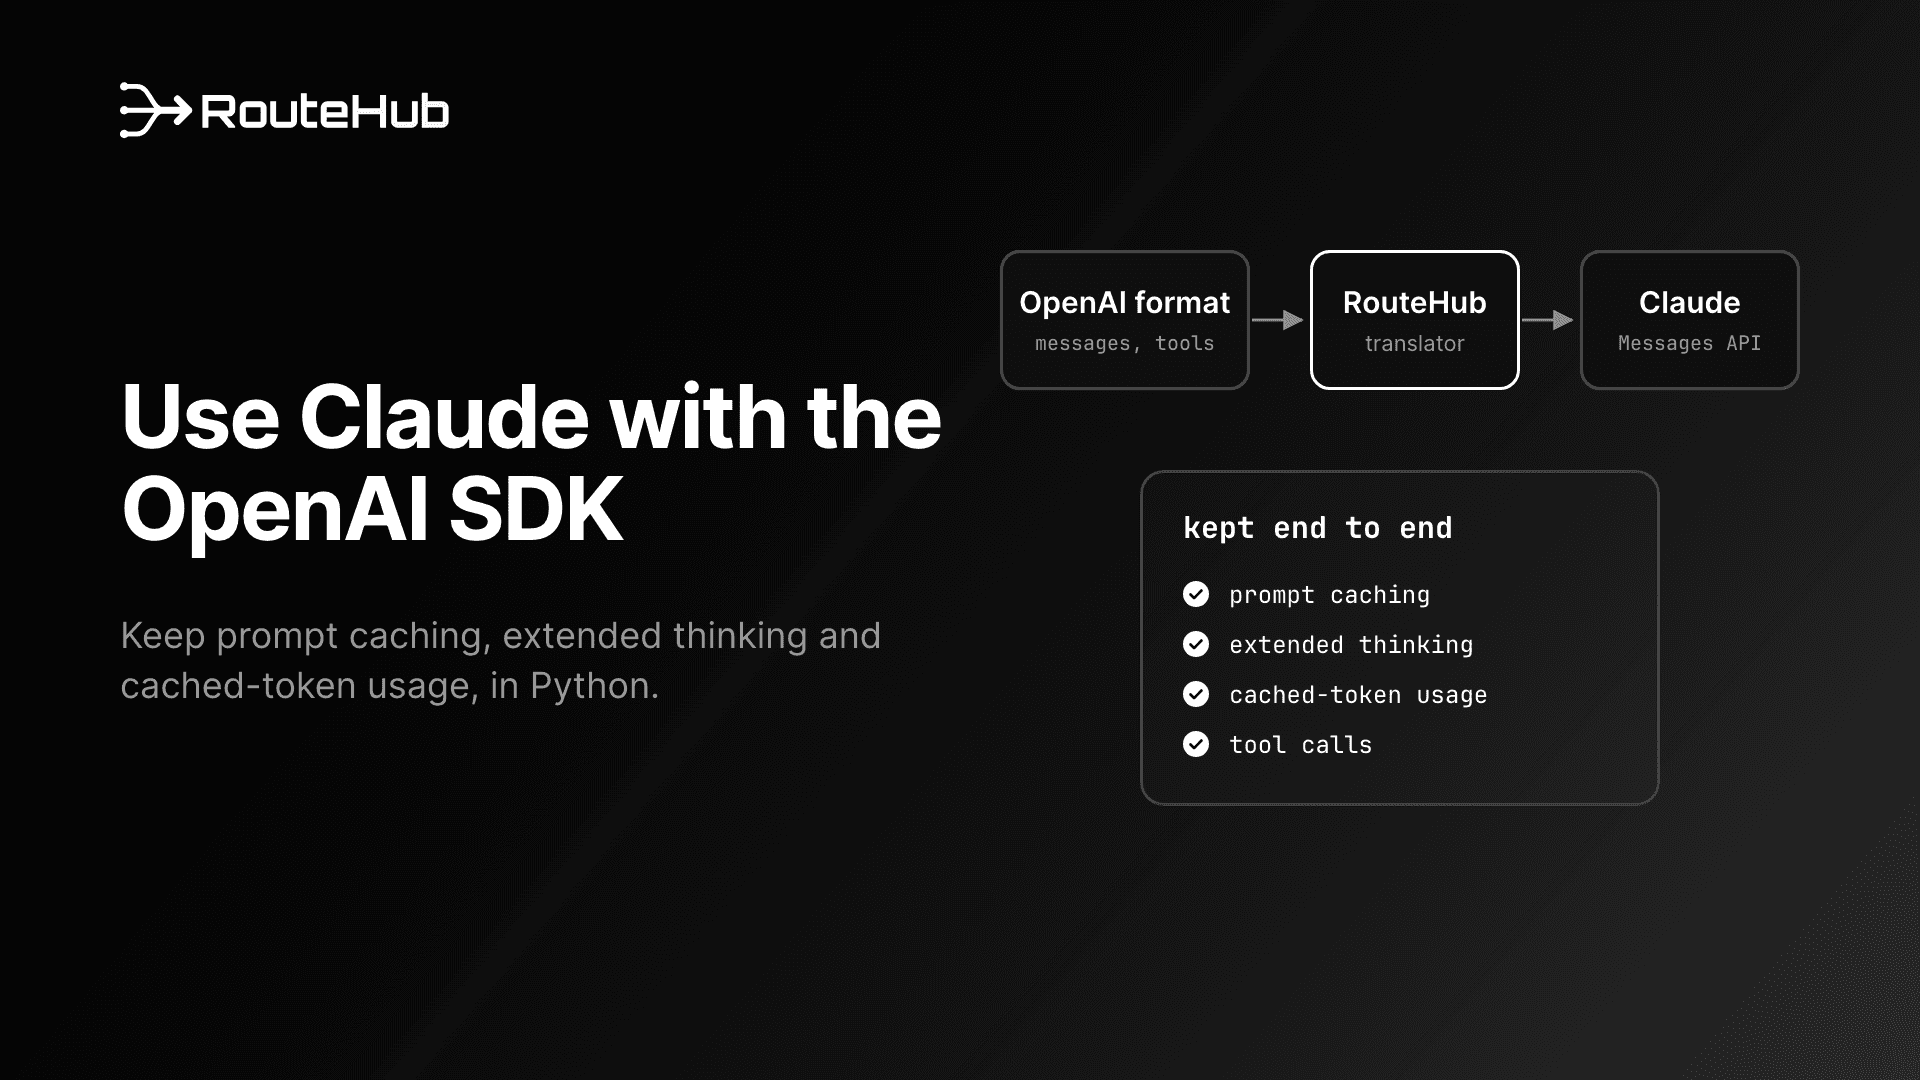
了解如何在 Python 中通过 OpenAI SDK 格式使用 Claude、Anthropic 兼容端点会丢掉哪些功能,以及如何保留提示缓存、思考输出和 PDF 支持。