指南工程
LiteLLM 为什么慢?导入时间、单次调用开销以及解决方法
LiteLLM 为什么慢?我们实测了它约 1.2 秒的导入时间、单次调用开销、流式输出成本和内存占用,并介绍官方文档中的优化方法,以及什么时候应该换用其他网关。
Swarms 团队11 分钟阅读

LiteLLM 为什么慢?我们实测了它约 1.2 秒的导入时间、单次调用开销、流式输出成本和内存占用,并介绍官方文档中的优化方法,以及什么时候应该换用其他网关。
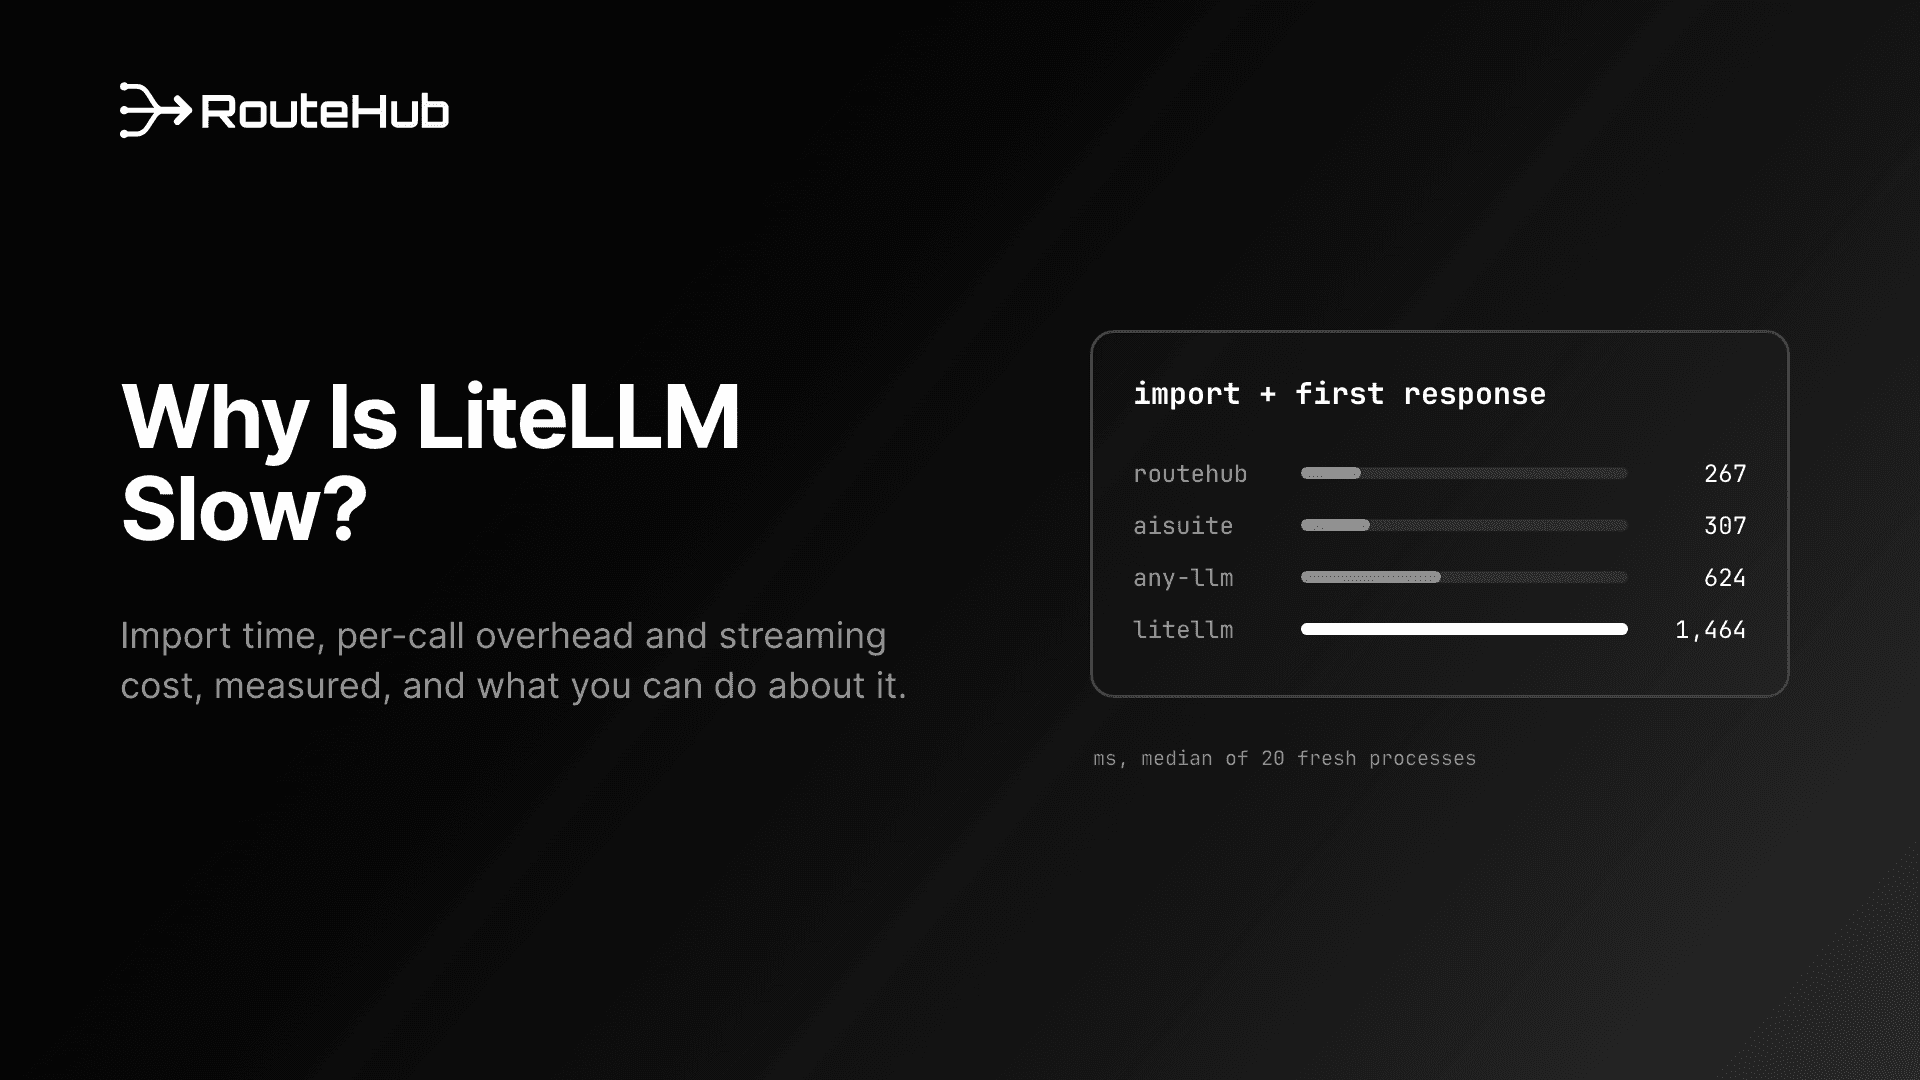
如果你的 Python 应用启动慢、第一次请求慢,或者在流式输出时 CPU 占用很高,而它又是通过 LiteLLM 调用模型的,那么网关很可能就是原因所在。LiteLLM 慢主要体现在四个地方:import litellm 所花的时间、每次调用额外做的工作、每个流式分块消耗的 CPU,以及进程占用的内存。本文逐一测量这些开销,解释时间花在了哪里,教你如何检查自己的应用,并列出 LiteLLM 官方文档中的优化方法。最后我们会说明,在哪些情况下换用另一个网关(例如 RouteHub)是更直接的解决办法,以及在哪些情况下 LiteLLM 仍然是更好的选择。
文中的数据有两个来源,每张表都会注明出处。大部分来自我们的技术报告 RouteHub: A Low-Overhead, SDK-Native LLM Gateway for Agentic Workloads,该报告在每个库各自独立的环境中,用一个即时响应的模拟服务器对 LiteLLM 1.104.0 做了基准测试。另有少量数据是我们为本文在 LiteLLM 1.104.2 上重新测量的,我们会在旁边注明所用的机器和方法。
人们通常会通过以下几种方式察觉到 LiteLLM 的延迟:
这些都不会改变模型回答所需的时间。它们是在你自己的进程里付出的开销,所以可以测量,也可以减少。
导入 LiteLLM 会加载大量代码。在论文的基准测试中,import litellm(1.104.0 版本)在 20 个新进程中的中位耗时为 1,235 毫秒,向 sys.modules 添加了 2,502 个模块,其中约 1,040 个是 LiteLLM 自己的模块,另外还有 OpenAI SDK、requests、aiohttp、jinja2、yaml 和 tokenizers。在发出任何请求之前,进程就已经占用了 194 MiB 内存。作为对比,裸 OpenAI SDK 的导入耗时为 217 毫秒,加载 782 个模块。
我们为本文在当前版本上重新测量了导入时间:
| 配置 | 导入时间中位数 | 新增模块数 |
|---|---|---|
| LiteLLM 1.104.2,默认设置 | 1,295 ms | 2,585 |
LiteLLM 1.104.2,LITELLM_LOCAL_MODEL_COST_MAP=True | 1,101 ms | 2,523 |
| RouteHub 0.2.0 | 3.2 ms | 18 |
我们的测量环境:Apple M3 Pro,macOS 15.7,Python 3.12.3,同一个 uv 环境中安装了 litellm 1.104.2、routehub 0.2.0 和 openai 2.54.0。先预热运行两次,然后每种配置交替运行 9 个新进程,环境变量只保留 PATH、HOME 和 LANG。
在同样的环境下(使用内置价格表)运行 python -X importtime -c "import litellm",可以看到时间花在了哪里:LiteLLM 自己的 1,104 个模块占了导入自身耗时的约 61%,剩下的大部分来自第三方包,例如 OpenAI SDK(含其依赖约 218 毫秒)和 aiohttp(约 60 毫秒)。换句话说,导入慢主要是因为 LiteLLM 会预先加载它的提供商集成、类型和工具函数,不管你的代码是否用得到。
LiteLLM 维护着一份包含模型价格、上下文窗口和能力信息的映射表。默认情况下,它会在导入过程中从 GitHub 获取最新版本,超时时间为 5 秒,获取失败时退回到包内自带的副本。这个网络请求就发生在你的 import 语句里。在论文中,它在作者的网络连接上让导入中位耗时增加了 145 毫秒;在我们上面的测量中,两种配置相差 194 毫秒。在较慢或受限的网络中,这个开销可能更大,而且启动还要依赖 GitHub 能否访问。
LiteLLM 的文档提供了一个关闭它的环境变量:设置 LITELLM_LOCAL_MODEL_COST_MAP=True,它就会改用内置的价格表。正如文档所说,代价是你只有在升级 LiteLLM 时才能拿到新的价格和模型。
进程预热之后,LiteLLM 在每个请求前后仍然会做额外的工作。论文用一个即时响应的模拟服务器,测量了 1,200 次顺序调用的延迟中位数,以此隔离客户端自身的开销:
| 相比裸提供商 SDK 增加的延迟 | 1 条消息的请求 | 22 条消息的智能体请求 |
|---|---|---|
| LiteLLM 1.104.0,OpenAI 路径 | +647 µs | +736 µs |
| LiteLLM 1.104.0,Anthropic 路径 | +567 µs | +669 µs |
| RouteHub,OpenAI 路径 | +9 µs | +32 µs |
| RouteHub,Anthropic 路径 | -159 µs | -161 µs |
来源:RouteHub 技术报告。在该环境下,裸 OpenAI SDK 处理一条消息的调用耗时 0.54 毫秒。负数表示比官方 SDK 更快。
论文把 LiteLLM 多出来的时间归结为它在每次调用中做的工作:创建一个日志对象,运行缓存和响应元数据钩子,把回复转换成它自己的响应类型,再把一个成功处理函数提交到后台线程池。在 cProfile 下,一个单消息请求经过 LiteLLM 会执行 10,576 次 Python 函数调用,而裸 OpenAI SDK 只有 5,961 次,剖析时间中有 26.7% 花在 LiteLLM 自己的包里。
我们还用 LiteLLM 文档中的 mock_response 选项对 1.104.2 做了性能剖析。这个选项会完全跳过网络和提供商 SDK,所以剩下的全是 LiteLLM 自己的工作。在上述机器上,每次调用的中位耗时为 0.51 毫秒,约 5,300 次函数调用。剖析结果中占比最大的几项是参数映射(get_optional_params)、响应元数据、模型信息查询,以及每次调用的成本计算。
对一条需要几秒钟生成的聊天消息来说,半毫秒无关紧要。但当它被成倍放大时就很重要了:一个要调用几百次模型的智能体,一个要在单个进程里每秒处理几千个请求的服务,或者一个对每次调用都使用模拟响应的测试套件。
流式输出会把每个事件的处理成本乘以分块数量。论文对来自即时模拟服务器的 200 分块流进行了计时:
| 200 分块的流 | 首个分块 | 完整流 | 每个分块 |
|---|---|---|---|
| LiteLLM 1.104.0,OpenAI 路径 | 16.61 ms | 61.1 ms | 224 µs |
| LiteLLM 1.104.0,Anthropic 路径 | 14.69 ms | 66.6 ms | 261 µs |
| 裸 OpenAI SDK | 1.00 ms | 9.8 ms | 44 µs |
| 裸 Anthropic SDK | 0.41 ms | 2.4 ms | 10 µs |
| RouteHub,Anthropic 路径 | 0.29 ms | 1.2 ms | 5 µs |
按每秒 100 个分块计算,每个分块约 0.2 毫秒的开销意味着每个打开的流要占用 2% 的 CPU 核心。一个同时服务 50 个流的进程,光是处理分块就要用掉大约一整个核心。如果你的流式服务器 CPU 很高,这很可能就是原因。
智能体经常在两次模型调用之间暂停,等待工具运行。暂停之后复用已打开的 HTTP 连接,可以省掉一次 TCP 和 TLS 握手。OpenAI SDK 使用的 httpx 默认会在连接池中的连接空闲 5 秒后将其关闭,而 LiteLLM 的同步 OpenAI 路径创建的是一个使用这些默认值的普通 httpx.Client。
论文在真实网络上测试了这一点:用一个故意无效的 key 向 api.openai.com 发送请求,这样就不涉及任何模型时间。在 10 秒的停顿之后,LiteLLM 的下一个请求耗时 185 毫秒,裸 OpenAI SDK 耗时 166 毫秒,因为两者都必须重新连接。RouteHub 会把连接保持 60 秒,它复用了原有连接,116 毫秒就得到响应。也就是说,只要工具调用超过五秒,每个智能体步骤大约会多花 67 毫秒;在一个 50 步的运行中,累计约 3.3 秒纯粹用于建立连接。这一点并不是 LiteLLM 特有的:它来自更适合浏览器而不是智能体的 HTTP 客户端默认设置。
在论文中,第一次请求之后 LiteLLM 的峰值内存为 211 MiB,是 RouteHub(54 MiB)的 3.9 倍,而裸 OpenAI SDK 为 53 MiB。LiteLLM 还会安装 58 个包(磁盘占用 168.5 MiB),RouteHub 只有 21 个。如果你在一台机器上运行很多 worker 进程,这决定了能放下多少个。
在做任何改动之前,先测量。这些检查只需几分钟,在任何机器上都能运行。
导入时间。 Python 内置的 -X importtime 参数会打印每个模块的导入耗时:
python -X importtime -c "import litellm" 2> importtime.txt
sort -t '|' -k2 -n importtime.txt | tail -20
如果想要一个简单的总耗时,可以在几个新进程中为导入计时,分别测试开启和关闭价格表下载的情况:
for i in 1 2 3 4 5; do
  python -c "import time; t = time.perf_counter(); import litellm; print(f'{(time.perf_counter() - t) * 1000:.0f} ms')"
done

for i in 1 2 3 4 5; do
  LITELLM_LOCAL_MODEL_COST_MAP=True python -c "import time; t = time.perf_counter(); import litellm; print(f'{(time.perf_counter() - t) * 1000:.0f} ms')"
done
单次调用开销。 mock_response 不调用提供商就直接返回响应,所以对它计时就能看出 LiteLLM 每次调用自身的工作量:
import os
os.environ.setdefault("LITELLM_LOCAL_MODEL_COST_MAP", "True")

import statistics
import time

import litellm

messages = [{"role": "user", "content": "Say hi"}]

def call():
    return litellm.completion(model="gpt-5.4-mini", messages=messages, mock_response="hi")

for _ in range(50):  # warm up
    call()

samples = []
for _ in range(500):
    start = time.perf_counter()
    call()
    samples.append((time.perf_counter() - start) * 1000)

print(f"median {statistics.median(samples):.3f} ms per call")
时间花在哪里。 cProfile 会统计每一次函数调用,比墙钟时间更稳定:
import cProfile
import pstats

import litellm

messages = [{"role": "user", "content": "Say hi"}]
litellm.completion(model="gpt-5.4-mini", messages=messages, mock_response="hi")

with cProfile.Profile() as profiler:
    for _ in range(200):
        litellm.completion(model="gpt-5.4-mini", messages=messages, mock_response="hi")

stats = pstats.Stats(profiler)
print(f"{stats.total_calls / 200:.0f} function calls per request")
stats.sort_stats("cumulative").print_stats(15)
用你真实的模型和网络运行同样的脚本,看看 LiteLLM 在端到端延迟中占了多少。如果占比很小,下面的优化方法可能就足够了。
以下方法都在 LiteLLM 内部生效,并且有 LiteLLM 项目或 Python 本身的文档支持。
1. 使用内置价格表。 在导入 LiteLLM 之前,在环境中设置 LITELLM_LOCAL_MODEL_COST_MAP=True。这会去掉 import litellm 中的网络请求,启动时也不再依赖 GitHub。在我们的测量中,这节省了 194 毫秒。记得升级 LiteLLM 以获取新的模型和价格。
2. 在生产环境关闭调试日志。 LiteLLM 的延迟排查指南指出,DEBUG 日志是大负载请求延迟的首要原因,并建议使用 LITELLM_LOG=INFO。如果你在开发时打开了调试输出,请确保在注重性能的环境中关闭它。
3. 每个进程只付一次导入成本。 如果你的应用在每个命令或测试都会加载的模块顶部导入 LiteLLM,可以把导入移到真正发送请求的函数内部。这样 Python 只会在该函数第一次运行时导入 LiteLLM,从不调用模型的命令和测试就能省掉这笔开销。这只是推迟了成本,并没有消除它。对于服务器,请使用长期运行的 worker,让导入只在启动时发生一次,而不是每个请求一次。
4. 为异步调用复用 HTTP 会话。 LiteLLM 支持向 acompletion() 传入一个 shared_session(一个 aiohttp.ClientSession),让多次调用复用同一组连接,而不是每次新建。在启动时创建一次会话,在关闭时将其关闭。
5. 高并发时使用异步 API。 LiteLLM 的异步调用默认使用 aiohttp 传输层(见 LiteLLM 设置中的 disable_aiohttp_transport)。在论文的吞吐量测试中,LiteLLM 的吞吐量随着并发升高保持平稳,在同时有 128 个请求在途时,它在 OpenAI 路径上每秒处理的请求数超过了 RouteHub 和裸 OpenAI SDK。如果你要在一个进程里并发发出大量请求,配合共享会话使用 acompletion() 是 LiteLLM 表现最好的配置。
上面的方法去掉了导入时的网络请求,也避免了为用不到的东西付出代价。但它们不会改变 LiteLLM 加载的代码量,也不会改变它每次调用所做的工作:
如果这些开销在你的测量中很明显,下一步就是换一个热路径更短的网关。
RouteHub 是一个开源网关,沿用了 LiteLLM 的函数名和模块路径,所以大多数代码只需要换一行导入。它在请求真正需要之前不加载任何东西,导入时不发起任何网络请求,返回 OpenAI SDK 自己的响应对象,在智能体步骤之间保持客户端和连接存活,并直接调用 Anthropic 的原生 Messages API。这些设计各自如何实现,可以阅读我们的发布文章。
论文中与 LiteLLM 1.104.0 的对比数据:
| LiteLLM | RouteHub | |
|---|---|---|
| 导入 | 1,235 ms | 3.2 ms(快 383 倍) |
| 导入 + 首个响应 | 1,464 ms | 267 ms(快 5.5 倍) |
| 首次请求后的峰值内存 | 211 MiB | 54 MiB(少 3.9 倍) |
| 每次调用增加的延迟,OpenAI 路径 | +647 µs | +9 µs |
| 每个请求的 Python 函数调用次数 | 10,576 | 6,031 |
| 每个流式分块,Anthropic 路径 | 261 µs | 5 µs |
| 停顿 10 秒后的下一个请求(真实网络) | 185 ms | 116 ms |
| 安装的包数量 | 58 | 21 |
迁移通常是这样的:
# Before
from litellm import completion

# After
from routehub import completion

response = completion(
    model="claude-sonnet-4-6",
    messages=[{"role": "user", "content": "Summarize our Q3 risks in three bullets."}],
    num_retries=3,
)
print(response.choices[0].message.content)
有两点需要提前规划:RouteHub 的设置是每次调用的参数,而不是模块级全局变量(litellm.num_retries = 3 变成 completion(..., num_retries=3));响应是 OpenAI SDK 对象,要用属性而不是字典键来读取。我们的迁移指南介绍了更多细节。可以从 PyPI 安装:pip install routehub 或 uv add routehub。
在一些情况下 LiteLLM 是合适的工具,基准测试中也有一项它更快:
想并排比较各个选项,可以阅读最好的 Python LLM 网关和最好的 LiteLLM 替代方案。如果你主要调用 Claude,用 OpenAI 格式在 Python 中调用 Claude 的指南介绍了原生 Anthropic 路径。
import litellm 这么慢?它在导入时会加载约 2,500 个模块,包括 LiteLLM 的提供商集成和 OpenAI SDK,并且默认会从 GitHub 下载模型价格表。论文测得 LiteLLM 1.104.0 的导入耗时为 1,235 毫秒,我们测得 1.104.2 为 1,295 毫秒。
LITELLM_LOCAL_MODEL_COST_MAP 有什么作用?设置为 True 时,LiteLLM 会使用包内自带的价格和上下文窗口映射表,而不是在导入时从 GitHub 获取最新版本。这会去掉启动过程中的一个网络请求。之后要获取新的模型和价格,需要升级 LiteLLM。
在论文的模拟服务器基准测试中,与裸 OpenAI SDK 相比,LiteLLM 1.104.0 在单消息的 OpenAI 调用上增加了 647 微秒,在 22 条消息的智能体请求上增加了 736 微秒。流式输出时每个分块增加约 224 到 261 微秒。
对于单个交互式请求,通常不重要。当开销被成倍放大时它才重要:无服务器函数的冷启动、要调用几百次模型的智能体、同时处理很多流的服务器,以及运行大量模拟调用的测试套件。
对大多数代码来说只需要换一行导入,因为 RouteHub 沿用了 LiteLLM 的函数名和模块路径。设置从模块级全局变量改为每次调用的参数,响应是 OpenAI SDK 对象而不是 LiteLLM 自己的类型。预算、花费记录等代理功能不属于 RouteHub。
有。在论文的基准测试中,当单个进程同时有 128 个异步请求时,LiteLLM 的 aiohttp 传输层在 OpenAI 和 Anthropic 路径上每秒处理的请求数都超过了默认安装的 RouteHub。在较低并发下,以及在启动、单次调用延迟、流式输出、内存和连接复用方面,RouteHub 都更快。
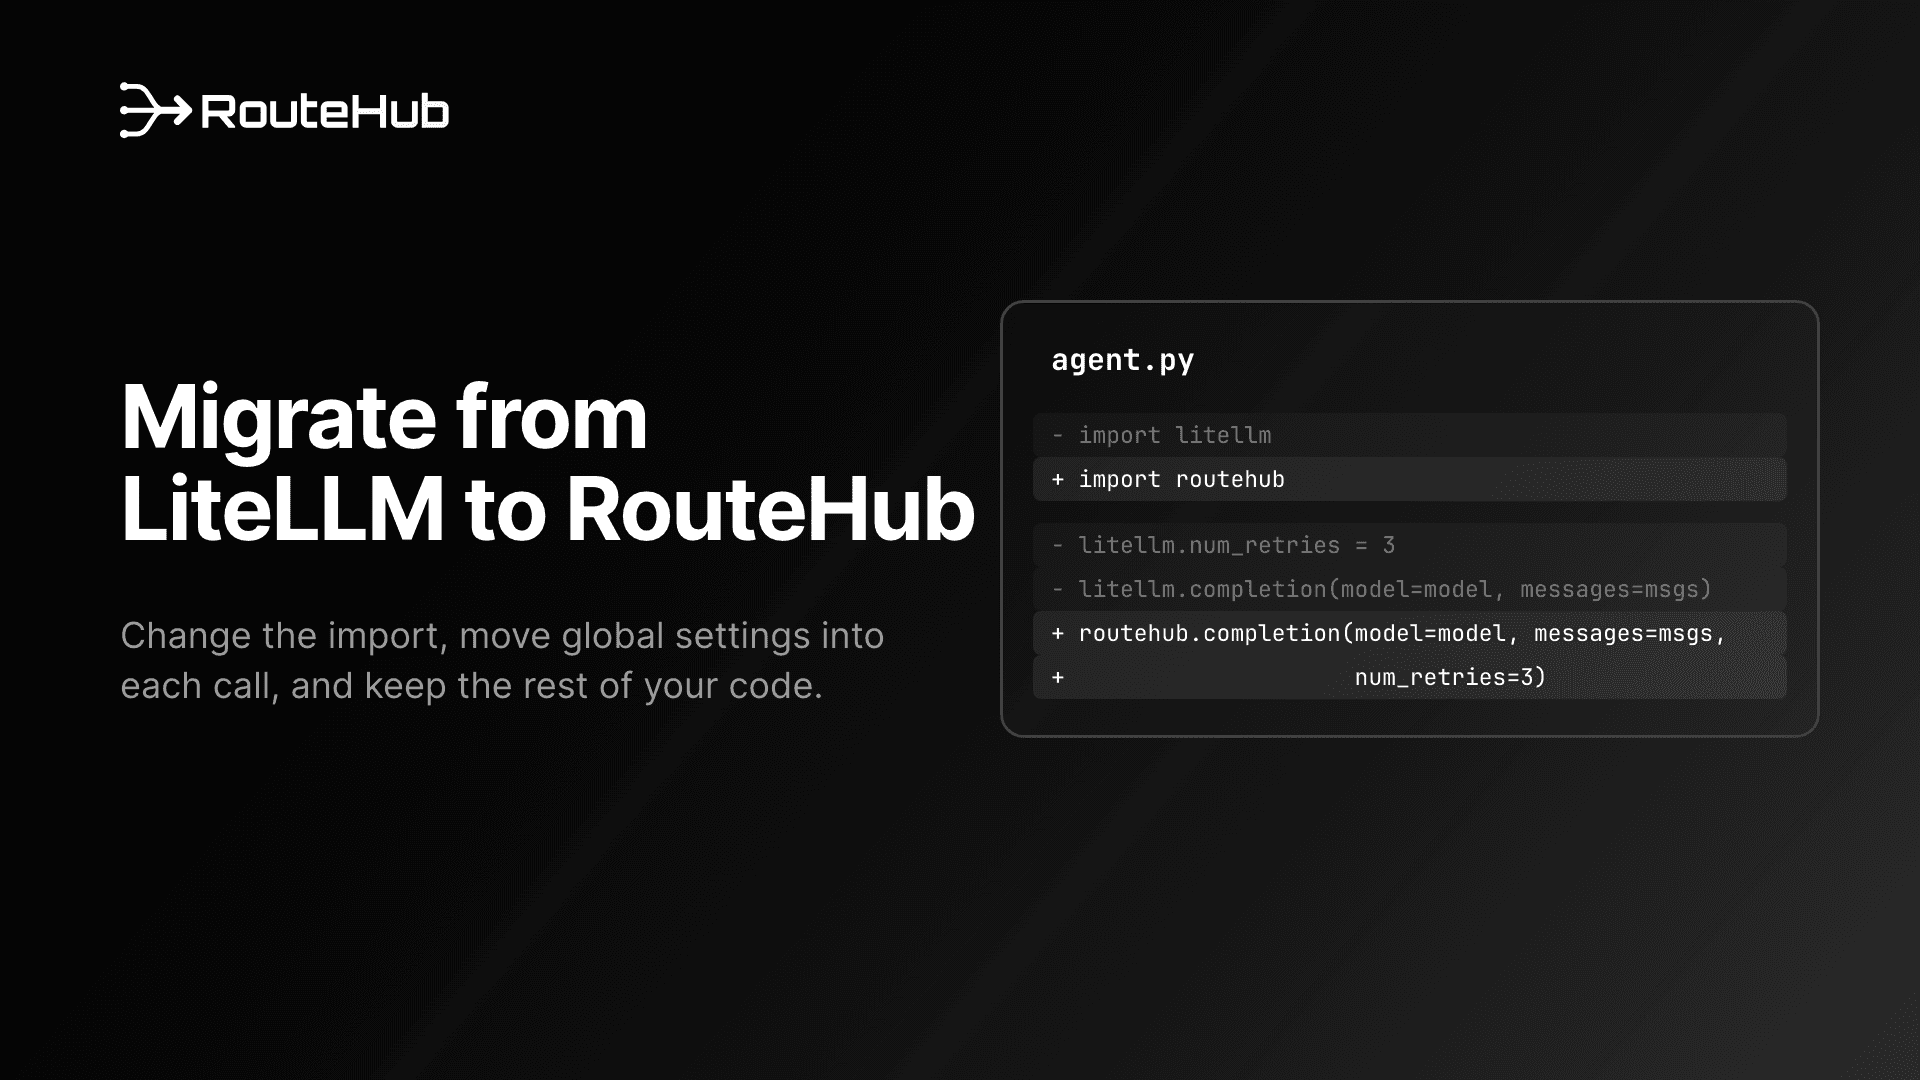
从 LiteLLM 迁移到 RouteHub 的分步指南:替换导入,把 litellm 全局设置改为每次调用的参数,并更新响应读取、工具调用、异常处理和测试。
RouteHub 是一个开源 LLM 网关,通过一个 API 连接 20 多家模型提供商,支持流式输出、异步调用和工具调用。它的导入速度比 LiteLLM 快 383 倍,拿到首个响应快 5.5 倍,内存占用少 3.9 倍,每次调用只增加 9 微秒开销,在 Claude 调用和流式输出上比官方 Anthropic SDK 还快。本文介绍它的工作原理、完整的基准测试结果,以及如何上手。
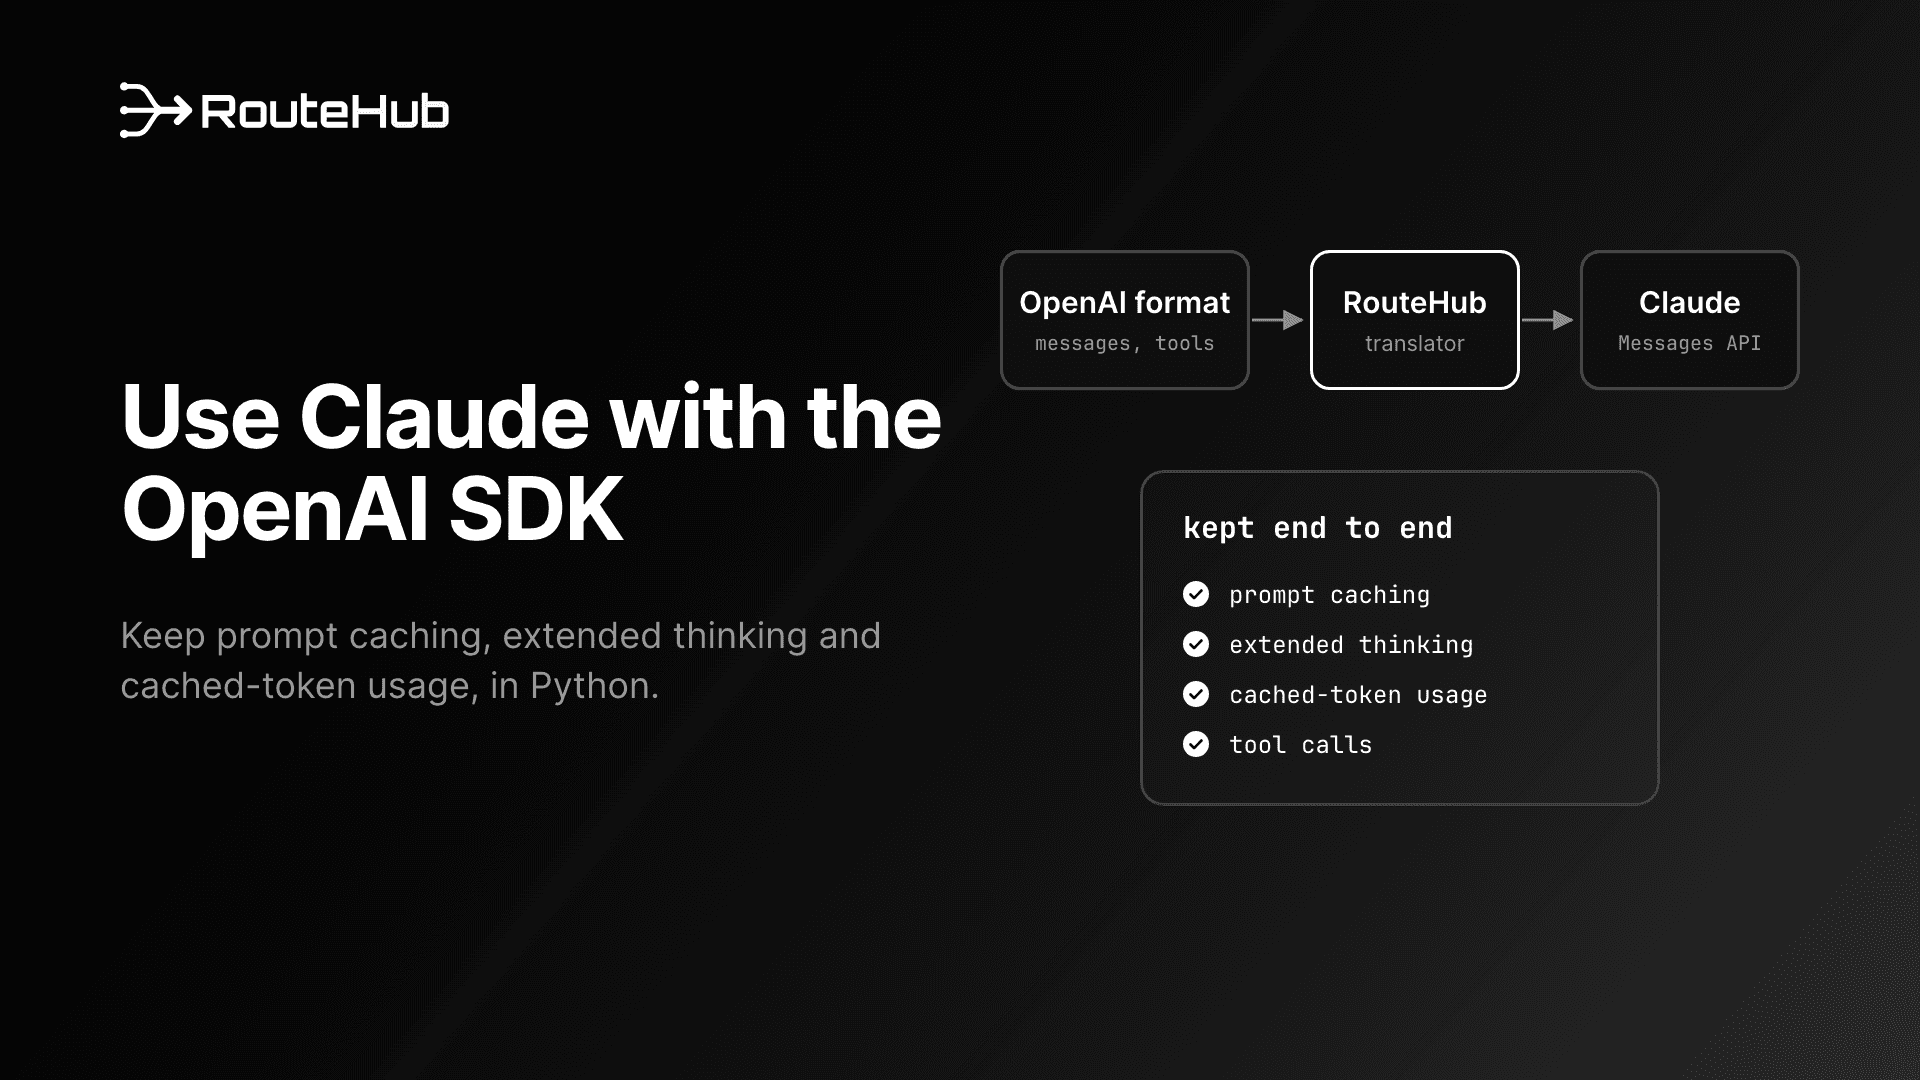
了解如何在 Python 中通过 OpenAI SDK 格式使用 Claude、Anthropic 兼容端点会丢掉哪些功能,以及如何保留提示缓存、思考输出和 PDF 支持。