对比指南
2026 年最佳 Python LLM 网关:RouteHub、LiteLLM、any-llm、aisuite 对比
正在寻找最佳 Python LLM 网关?我们从启动时间、单次调用开销、流式输出和功能等方面,对比 RouteHub、LiteLLM、any-llm 和 aisuite。
Swarms 团队13 分钟阅读

正在寻找最佳 Python LLM 网关?我们从启动时间、单次调用开销、流式输出和功能等方面,对比 RouteHub、LiteLLM、any-llm 和 aisuite。
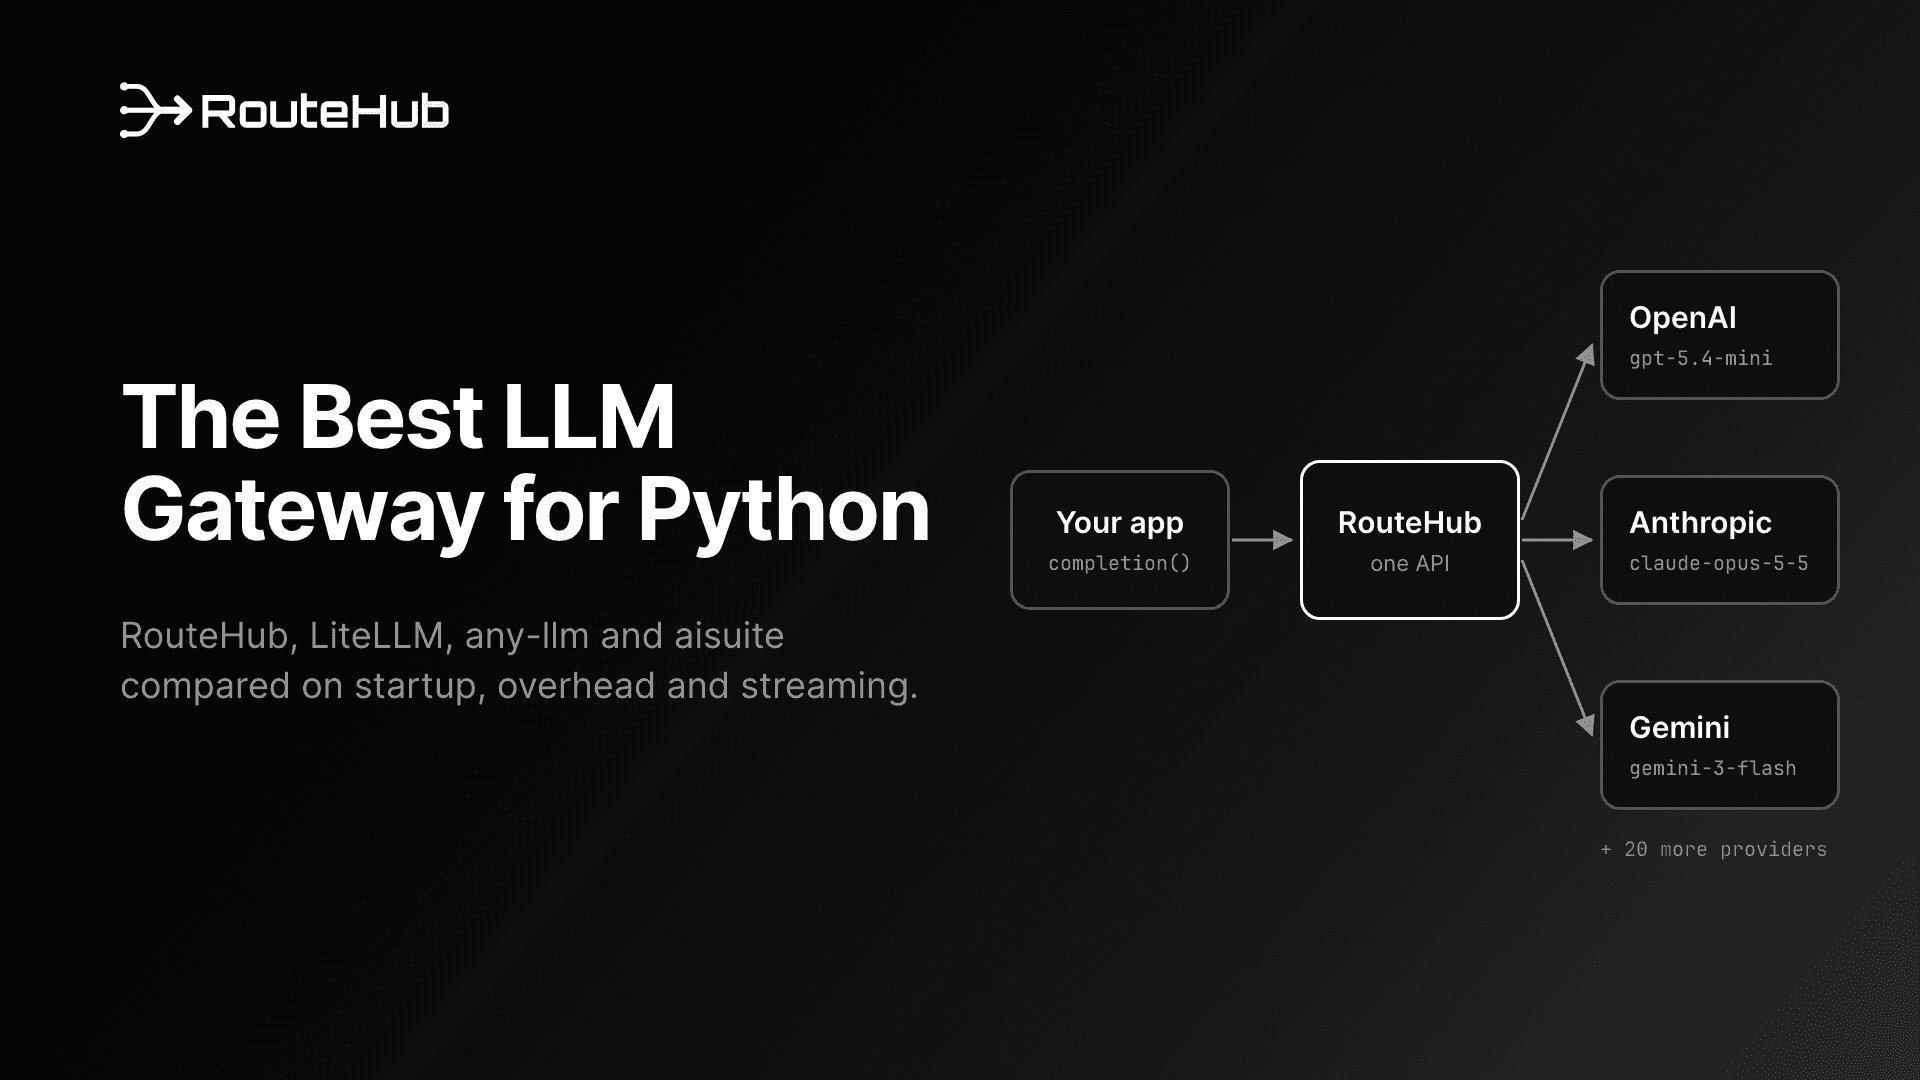
选择最佳 Python LLM 网关,就是选择那个位于你的代码和每一家模型提供商之间的库。它决定了进程启动有多快、每个请求在客户端代码里花多少时间、提示缓存等 Claude 功能能否完整保留,以及有多少个包会带着你的 API key 运行。本文对比四个 Python LLM 网关库:RouteHub、LiteLLM、any-llm 和 aisuite,并说明什么时候你需要的是代理服务器而不是库。
开始之前先说明:RouteHub 是我们开发的。下文的每一个基准测试数字都来自我们的技术报告,测试中每个库都运行在各自的环境里,面对同一个模拟服务器。其他库做得更好的地方,我们也会直接指出。关于其他项目的事实都来自它们自己的仓库和文档,文中附有链接。
AnyLLM 客户端。openai 1.x 版本。本文接下来解释我们是如何得出这些结论的。
LLM 网关让你的应用用同一种方式调用多家模型提供商。你只需按一种格式写请求,通常是 OpenAI Chat Completions 格式,网关会把它发给 OpenAI、Anthropic、Gemini、Groq、Mistral、本地的 Ollama 服务器,或者模型字符串指定的任何提供商。响应、流式分块、工具调用、token 用量和错误都以同一种形式返回,所以其余代码不需要关心是哪家提供商给出的回答。
网关有两种形式:
人们也把它称为 Python 统一 LLM API 或多提供商 LLM 客户端。思路都一样:一种调用方式,多家提供商。
大多数团队一开始只用一家提供商的 SDK,等到需要第二家提供商时才引入网关。网关可以让你:
gpt-5.4-mini 换成 claude-sonnet-4-6,调用周围的代码都不用动。智能体让这些问题更突出,因为网关自身的开销会反复出现。智能体在模型调用和工具调用之间来回切换,持续几十甚至几百步,所以单次调用的开销每一步都要付一次。无服务器函数、CLI 工具、测试套件和按任务启动的 worker 每次启动都要付出网关的导入时间。多智能体系统同时发出大量请求,所以每个请求、每个流式分块消耗的 CPU 决定了一个进程能承载多少工作。对单条聊天消息来说,这些开销和模型延迟相比很小;但在整个智能体运行过程中,它们会累积起来,这也是下文对比重点关注它们的原因。我们在为什么 LiteLLM 导入很慢一文中有更深入的分析。
当多个应用或团队共享模型访问权限,而你希望在一个地方统一管理时,代理就很合适:
npx @portkey-ai/gateway 或 Docker 启动它,它提供自动重试、回退、负载均衡、条件路由、护栏和缓存。Portkey 也提供托管版本。代理会给每个请求增加一次网络跳转,自托管的代理还是一个需要部署和监控的服务。库不会增加跳转,也不需要额外运行任何东西。两者也可以很好地组合:RouteHub 可以用 openrouter/ 模型前缀调用 OpenRouter,也可以通过 api_base= 指向任何兼容 OpenAI 的服务器,包括 LiteLLM Proxy。
本文其余部分对比的是库形式的网关,因为无论如何,每个 Python 应用都要做这个选择。
以下是在实际使用中区分这些库的标准:
import 需要多久,以及在新进程中拿到首个响应需要多久。litellm.drop_params 或 litellm.ssl_verify,会影响进程中的每一个调用方。按调用设置(RouteHub 只提供这一种方式)可以让租户和智能体互不影响。RouteHub 是我们为 Swarms 智能体框架开发的网关。它沿用了 LiteLLM 的函数名和模块路径(completion、acompletion、embedding、routehub.utils、routehub.exceptions),所以迁移过来基本只需要改导入。对兼容 OpenAI 的提供商,它通过官方 OpenAI SDK 发送请求,并原样返回 SDK 自己的 ChatCompletion 对象。对 Claude,它通过自己的适配器调用 Anthropic 原生的 Messages API,所以提示缓存、思考和缓存 token 统计都能正常工作。它导入时什么都不加载,在真正发出请求之前不访问网络,在智能体步骤之间把 HTTP 连接保持 60 秒,所有设置都作为调用参数传入。它只有三个直接依赖:openai、pydantic 和 tiktoken。
LiteLLM 由 BerriAI 开发,覆盖 100 多家提供商,同时提供 Python SDK 和 LiteLLM Proxy 服务器,还有费用追踪、护栏、负载均衡和日志功能。它的很多设置是模块级全局变量,例如 litellm.drop_params 和 litellm.num_retries,返回的是它自己的 ModelResponse 类型。LiteLLM 的 README 现在还介绍了 Rust 内核,以及一个单独的 Python SDK 发行包 litellm-core,其发布集成仍在进行中,所以较新的版本可能与我们测试的版本表现不同。
any-llm 由 Mozilla.ai 开发,通过各家提供商的官方 SDK 发送请求。它提供 completion() 等模块级函数,每次调用都会新建一个客户端;还提供 AnyLLM 类,会复用客户端,这也是它的 README 推荐的生产环境用法。模型字符串的格式是 openai:gpt-4o,也可以单独传入 provider=。它的响应类型是 OpenAI SDK 类型的子类。至于预算、key 管理和分析功能,Mozilla.ai 指向的是另一个项目 Otari 网关。any-llm 需要 Python 3.11 或更高版本。
aisuite 是一个轻量级库,托管在吴恩达(Andrew Ng)的 GitHub 账号下。它有两层:统一的 Chat Completions API(client.chat.completions.create,模型字符串如 anthropic:claude-3-5-sonnet-20240620),以及带工具、工具包和 MCP 支持的 Agents API。提供商 SDK 以 extras 的形式安装,它的 openai extra 要求 openai<2.0.0,这可能与其他需要当前 SDK 的包冲突。它返回的是自己的 ChatCompletionResponse 类,结构与 OpenAI 的相似。
| RouteHub | LiteLLM | any-llm | aisuite | |
|---|---|---|---|---|
| 维护方 | The Swarm Corporation | BerriAI | Mozilla.ai | andrewyng/aisuite |
| 许可证 | Apache 2.0 | MIT(enterprise/ 目录以外) | Apache 2.0 | MIT |
| Python | 3.10+ | 3.10+ | 3.11+ | 3.10+ |
| 模型字符串 | groq/llama-3.3-70b-versatile | openai/gpt-4o | openai:gpt-4o | openai:gpt-4o |
| 提供商 | 20 多家 | 100 多家 | 多家,通过官方 SDK | OpenAI、Anthropic、Google、Mistral、AWS、Ollama 等 |
| 响应类型 | OpenAI SDK 的 ChatCompletion | LiteLLM 的 ModelResponse | OpenAI SDK 类型的子类 | aisuite 的 ChatCompletionResponse |
| 代理服务器 | 无 | LiteLLM Proxy | 单独项目(Otari) | 无 |
以下数字来自 RouteHub 技术报告。我们测试了 RouteHub、LiteLLM 1.104.0、any-llm 1.30.0 和 aisuite 0.2.0,并以裸 OpenAI SDK 和 Anthropic SDK 作为下限参照。由于这些库的版本要求互相冲突,每个库都运行在各自的虚拟环境中,每次测量都在全新进程中进行,不设置任何 API key 或代理。请求发往同一台机器上一个即时响应的模拟服务器,所以这些数字只衡量客户端的工作。为了让 LiteLLM 处于最佳状态,我们关闭了它从 GitHub 下载价格表的功能。所有测试都在一台 Apple M3 Pro 笔记本上用 Python 3.12 完成。此后 PyPI 上的 LiteLLM 已更新到 1.104.2,any-llm 更新到 1.33.0,所以请把这些结果看作所测版本的一次快照。
| 库 | 导入 | 导入 + 首个响应 | 峰值内存 |
|---|---|---|---|
| RouteHub | 3.2 ms | 267 ms | 54 MiB |
| OpenAI SDK(裸调用) | 217 ms | 258 ms | 53 MiB |
| aisuite | 93 ms | 307 ms | 59 MiB |
| any-llm(函数) | 569 ms | 624 ms | 87 MiB |
| LiteLLM | 1,235 ms | 1,464 ms | 211 MiB |
RouteHub 的导入速度比 LiteLLM 快 383 倍,拿到首个响应快 5.5 倍,与裸 OpenAI SDK 只差 9 毫秒,峰值内存少 3.9 倍。RouteHub 把 OpenAI SDK 的加载推迟到第一次请求,所以“导入 + 首个响应”才是公平的比较。
下表为预热后顺序调用的延迟中位数,单位为毫秒(每项 1,200 次调用)。智能体请求包含 22 条消息和四个工具。
| 库 | OpenAI,1 条消息 | OpenAI,智能体 | Anthropic,1 条消息 | Anthropic,智能体 |
|---|---|---|---|---|
| 提供商 SDK(裸调用) | 0.54 | 2.04 | 0.42 | 0.45 |
| RouteHub | 0.55 | 2.08 | 0.26 | 0.29 |
| aisuite | 0.51 | 2.08 | 0.46 | 1.25 |
| any-llm(AnyLLM 客户端) | 0.75 | 2.40 | 0.69 | 1.48 |
| any-llm(函数) | 1.58 | 3.20 | 13.16 | 11.99 |
| LiteLLM | 1.19 | 2.78 | 0.98 | 1.12 |
在 OpenAI 路径上,aisuite 和 RouteHub 都接近裸 SDK。LiteLLM 每次调用增加 647 微秒,any-llm 的客户端增加 210 微秒。在 Anthropic 路径上,RouteHub 比 Anthropic SDK 本身还快,因为它的适配器只对请求编码一次,并把回复直接读入 ChatCompletion。any-llm 的模块级函数每次调用都新建客户端,在 Anthropic 路径上代价很高;它的 AnyLLM 客户端可以避免这个问题。
下表为消费一个 200 分块的流所需的时间,单位为毫秒(取 200 个流的中位数):
| 库 | OpenAI,首个分块 | OpenAI,完整流 | Anthropic,首个分块 | Anthropic,完整流 |
|---|---|---|---|---|
| 提供商 SDK(裸调用) | 1.00 | 9.8 | 0.41 | 2.4 |
| RouteHub | 0.82 | 9.1 | 0.29 | 1.2 |
| aisuite | 0.68 | 8.1 | 0.49 | 3.0 |
| any-llm(AnyLLM 客户端) | 7.42 | 11.8 | 7.36 | 9.9 |
| LiteLLM | 16.61 | 61.1 | 14.69 | 66.6 |
在这项测试的 OpenAI 路径上,aisuite 最快。在 Anthropic 路径上,RouteHub 完成一个流的时间只有 Anthropic SDK 的一半(每个分块 5 微秒对 10 微秒)。LiteLLM 每个分块要花 224 到 261 微秒。
下表为单个进程每秒处理的请求数(每个数据点 1,000 个请求,单条消息请求)。每个数据点只跑了一次,报告建议不要对相差约 10% 以内的结果排名。
| 库 | OpenAI,1 个在途 | OpenAI,128 个在途 | Anthropic,1 个在途 | Anthropic,128 个在途 |
|---|---|---|---|---|
| 提供商 SDK(裸调用) | 1,492 | 812 | 1,711 | 763 |
| RouteHub | 1,295 | 711 | 2,435 | 865 |
| aisuite | 1,308 | 215 | 1,304 | 1,152 |
| any-llm(AnyLLM 客户端) | 1,445 | 665 | 1,301 | 190 |
| LiteLLM | 792 | 876 | 907 | 942 |
这是其他库胜出的地方。当有 128 个请求在途时,LiteLLM 基于 aiohttp 的传输层在 OpenAI 路径上领先,aisuite 在 Anthropic 路径上领先。所有基于 httpx 的客户端在高并发下都会变慢,裸 SDK 也不例外,所以这时的瓶颈是 HTTP 库,而不是网关自己的代码。如果你的某个进程会同时保持 100 个以上的请求在途,请先用自己的工作负载测一测再做选择。
只安装各个库及其 OpenAI 和 Anthropic 所需 extras 的干净环境:
| 库 | 安装的包 | 磁盘占用 | .py 文件 |
|---|---|---|---|
| aisuite | 19 | 16.7 MiB | 2,539 |
| RouteHub | 21 | 22.9 MiB | 2,271 |
| any-llm | 26 | 28.0 MiB | 4,198 |
| LiteLLM | 58 | 168.5 MiB | 5,140 |
aisuite 安装的包最少,RouteHub 紧随其后,LiteLLM 安装的包将近三倍,其中包括 boto3、huggingface_hub、tokenizers、aiohttp 和 jinja2。
没有哪个库在所有场景下都是赢家。我们会这样选:
openai 1.x。 选 aisuite。AnyLLM 客户端而不是模块级函数。如果你已经在用 LiteLLM,想了解切换需要做什么,可以阅读我们的 LiteLLM 替代方案指南和分步迁移指南。
从 PyPI 安装 RouteHub:
pip install routehub

# Or with uv
uv add routehub

# With orjson for faster JSON handling
pip install "routehub[fast]"
设置提供商 key 并发起调用:
import routehub

messages = [{"role": "user", "content": "Summarize our Q3 risks in three bullets."}]

response = routehub.completion(model="gpt-5.4-mini", messages=messages)
print(response.choices[0].message.content)
改模型字符串就能切换提供商。重试和超时等设置都是调用参数:
routehub.completion(model="claude-sonnet-4-6", messages=messages, num_retries=3)
routehub.completion(model="gemini/gemini-3-flash-preview", messages=messages)
routehub.completion(model="openrouter/anthropic/claude-sonnet-4.6", messages=messages)
流式输出和异步调用使用同样的函数名:
import asyncio

for chunk in routehub.completion(model="claude-sonnet-4-6", messages=messages, stream=True):
    print(chunk.choices[0].delta.content or "", end="")

response = asyncio.run(
    routehub.acompletion(model="groq/llama-3.3-70b-versatile", messages=messages)
)
错误以类型化异常的形式抛出,这些异常继承自 OpenAI SDK 自己的异常,所以现有的 except openai.RateLimitError 处理代码可以继续使用:
try:
    routehub.completion(model="gpt-5.4-mini", messages=messages, num_retries=3)
except routehub.RateLimitError as error:
print(error.status_code, error.llm_provider, error.model)写测试时,mock_response 会返回一个真实的 ChatCompletion(或流),不需要网络请求,也不需要 API key:
response = routehub.completion(model="gpt-5.4-mini", messages=messages, mock_response="Approved.")
print(response.choices[0].message.content) # Approved.发布文章更详细地介绍了 RouteHub 的工作原理,README 则涵盖了所有提供商和选项。
取决于你需要它做什么。如果要在 Python 应用或智能体中获得最短的启动时间和最低的单次调用开销,RouteHub 在我们的基准测试中表现最好。如果需要带虚拟 key、预算和 100 多家提供商的共享代理,LiteLLM 的功能更完整。aisuite 的安装体积最小;如果你希望底层使用官方 SDK,并且使用 Python 3.11 或更高版本,any-llm 很合适。
对大多数代码来说很接近。RouteHub 使用相同的函数名和模块路径,主要改动就是导入。需要注意两点不同:设置是每次调用的参数,而不是模块级全局变量;响应是 OpenAI SDK 对象,要用属性读取,不能用字典键。迁移指南会一步步带你完成。
如果只有一个应用调用模型,并且你希望组件越少越好,就用库。如果多个应用或团队共享模型访问权限,需要集中管理 key、预算或日志,就用 LiteLLM Proxy、Portkey 或 OpenRouter 这样的代理。两者也可以同时使用:RouteHub 这样的库可以把请求发给兼容 OpenAI 的代理。
RouteHub 调用 Anthropic 原生的 Messages API,所以 cache_control 标记、扩展思考、带签名的思考块和缓存 token 用量都能完整传递。如果改为通过 Anthropic 的 OpenAI 兼容端点调用 Claude,Anthropic 的文档说明那里不支持提示缓存,也不会返回 Claude 的思考内容。
根据 RouteHub 技术报告,与 LiteLLM 1.104.0 相比,RouteHub 的导入速度快 383 倍(3.2 毫秒对 1,235 毫秒),拿到首个响应快 5.5 倍,峰值内存少 3.9 倍,在 OpenAI 路径上每次调用只增加 9 微秒,而 LiteLLM 增加 647 微秒。在 OpenAI 路径上有 128 个并发异步请求时,LiteLLM 更快。
支持。completion 和 acompletion 接受相同的参数,都支持流式输出、工具调用、结构化输出和推理设置,在不同提供商之间调用方式保持一致。RouteHub 以 Apache 2.0 许可证在 GitHub 上开源。
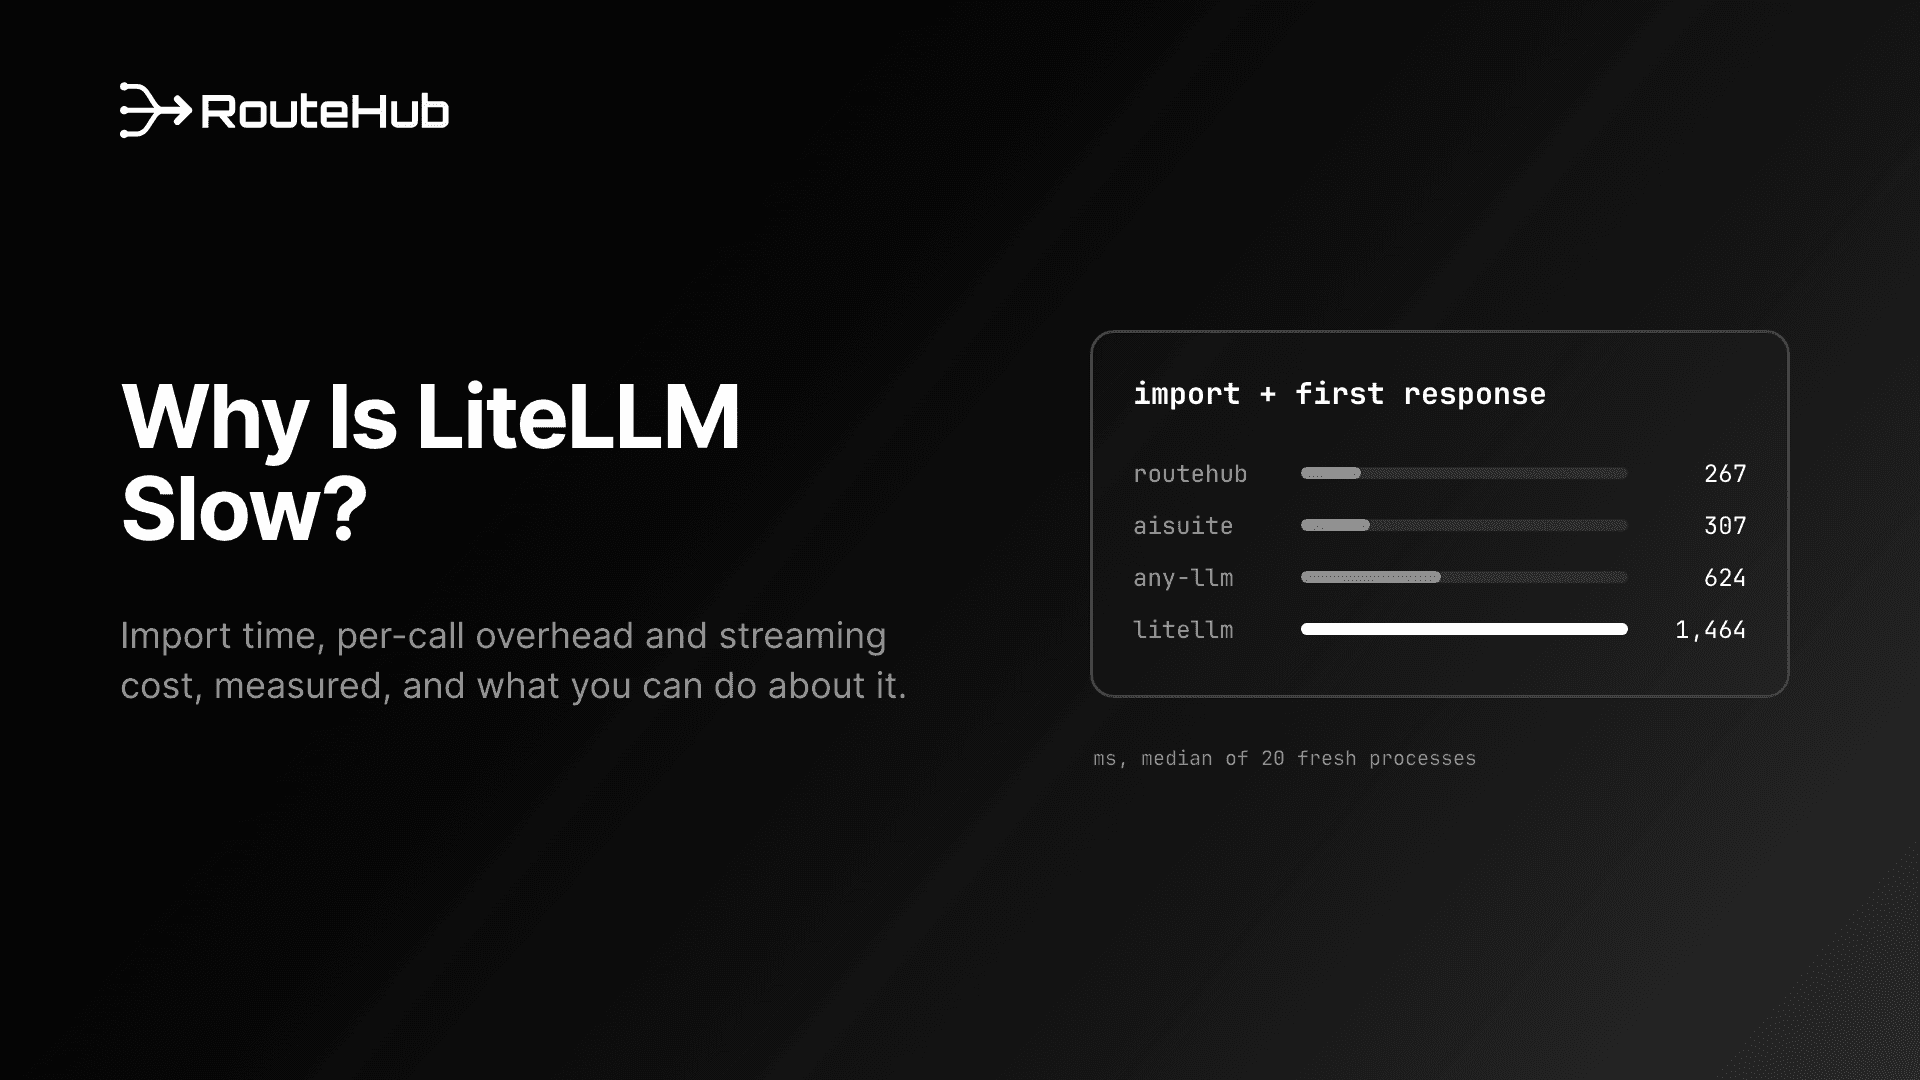
LiteLLM 为什么慢?我们实测了它约 1.2 秒的导入时间、单次调用开销、流式输出成本和内存占用,并介绍官方文档中的优化方法,以及什么时候应该换用其他网关。
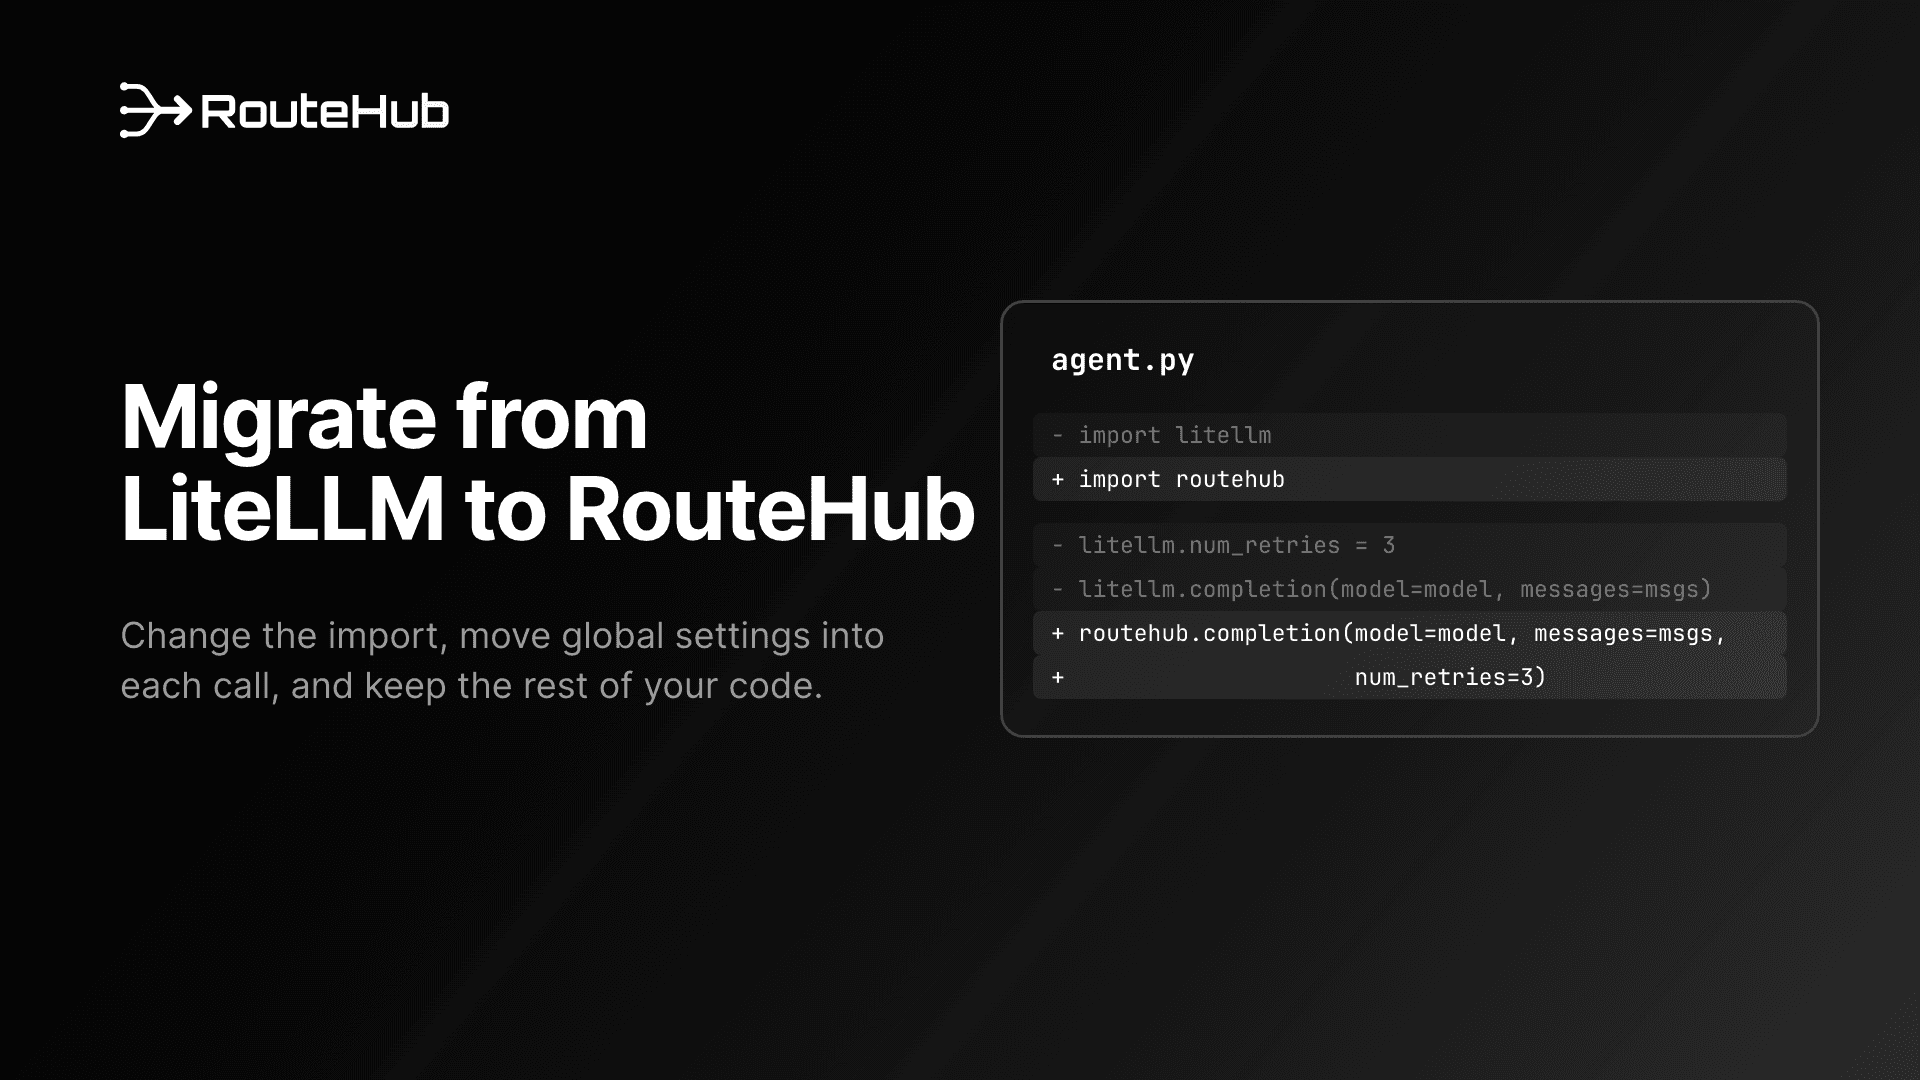
从 LiteLLM 迁移到 RouteHub 的分步指南:替换导入,把 litellm 全局设置改为每次调用的参数,并更新响应读取、工具调用、异常处理和测试。
RouteHub 是一个开源 LLM 网关,通过一个 API 连接 20 多家模型提供商,支持流式输出、异步调用和工具调用。它的导入速度比 LiteLLM 快 383 倍,拿到首个响应快 5.5 倍,内存占用少 3.9 倍,每次调用只增加 9 微秒开销,在 Claude 调用和流式输出上比官方 Anthropic SDK 还快。本文介绍它的工作原理、完整的基准测试结果,以及如何上手。